

AI検索とは何か、従来の検索との違いはどこにあるのかを、情報を探す工程と答えを作る工程に分けて図解します。引用元がどの段階で選ばれるのか、AI検索の回答は正確かという疑問まで、処理フローに沿って整理しました。
AI検索の仕組みは『探す工程』と『答えを作る工程』に分かれている
AI検索とは、質問に対して外部の情報を探す工程と、探した情報から回答文を作る工程の二つに分かれた仕組みです。前半で外部の情報を探し、後半でその情報から文章を組み立てる。前者を情報取得層、後者を回答生成層と呼び分けると、内部で何が起きているのかを一続きで追えるようになります。
この切り分けが実務で効くのは、自社サイトの見え方が層ごとに別の条件で決まるからです。ページが候補に上がるかどうかは取得層で決まり、その内容がどう言い換えられて回答文になるかは生成層で決まります。取得層で落ちているページと、取得はされたのに引用文に選ばれていないページでは、起きている問題も、直すべき箇所も違います。
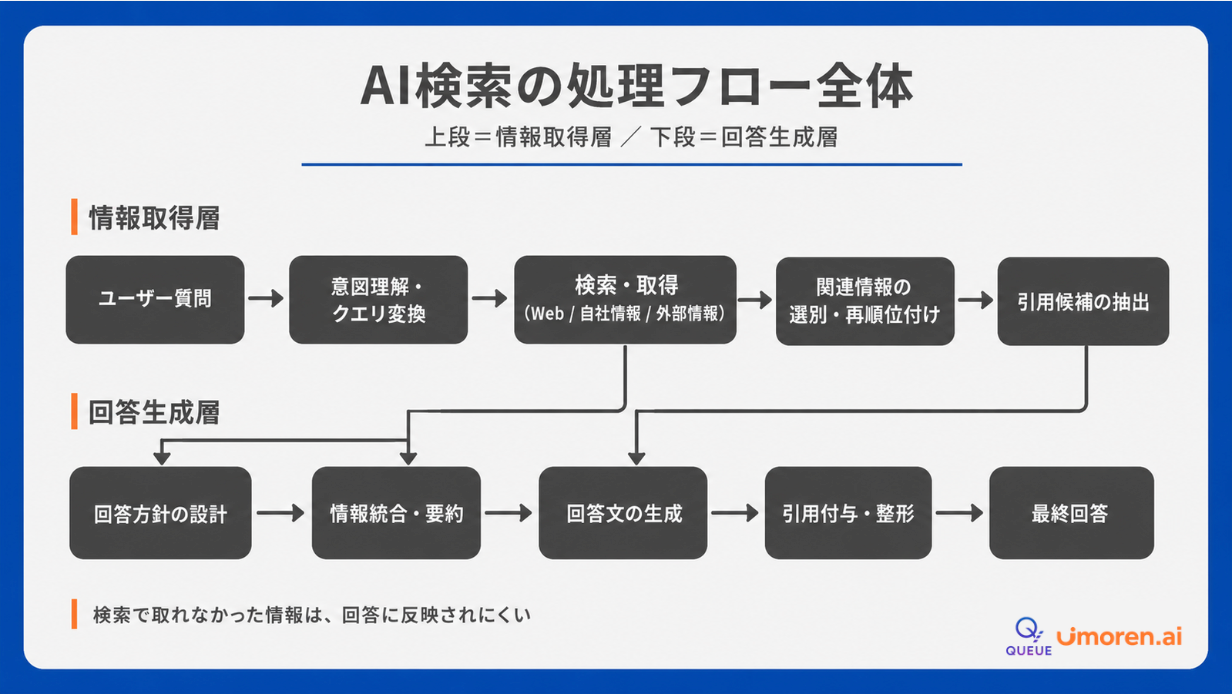
AI検索という言葉が指す範囲は広く、Google検索のAI Overviews、対話型のAI Mode、ChatGPT検索、Perplexity、Geminiなど、実装はサービスごとに異なります。ただし「質問を解釈して外部の情報源を引き当て、その内容を根拠に文章を組み立てる」という骨格は共通しています。個別の仕様を追いかける前にこの骨格を押さえておくと、機能が更新されるたびに理解をやり直さずに済みます。
検索エンジンそのものの評価構造がAI検索時代にどう変わったかは、関連記事『SEOとは?効果が出ない原因とAI検索時代の対策をわかりやすく解説』で詳しく解説しています。
以降は、二つの層で何が起きているのかを順に追い、最後に「自社ページがどの段階で止まっているか」を見分けられる形まで落とし込みます。
情報取得層:質問が分解され、断片が選ばれるまで
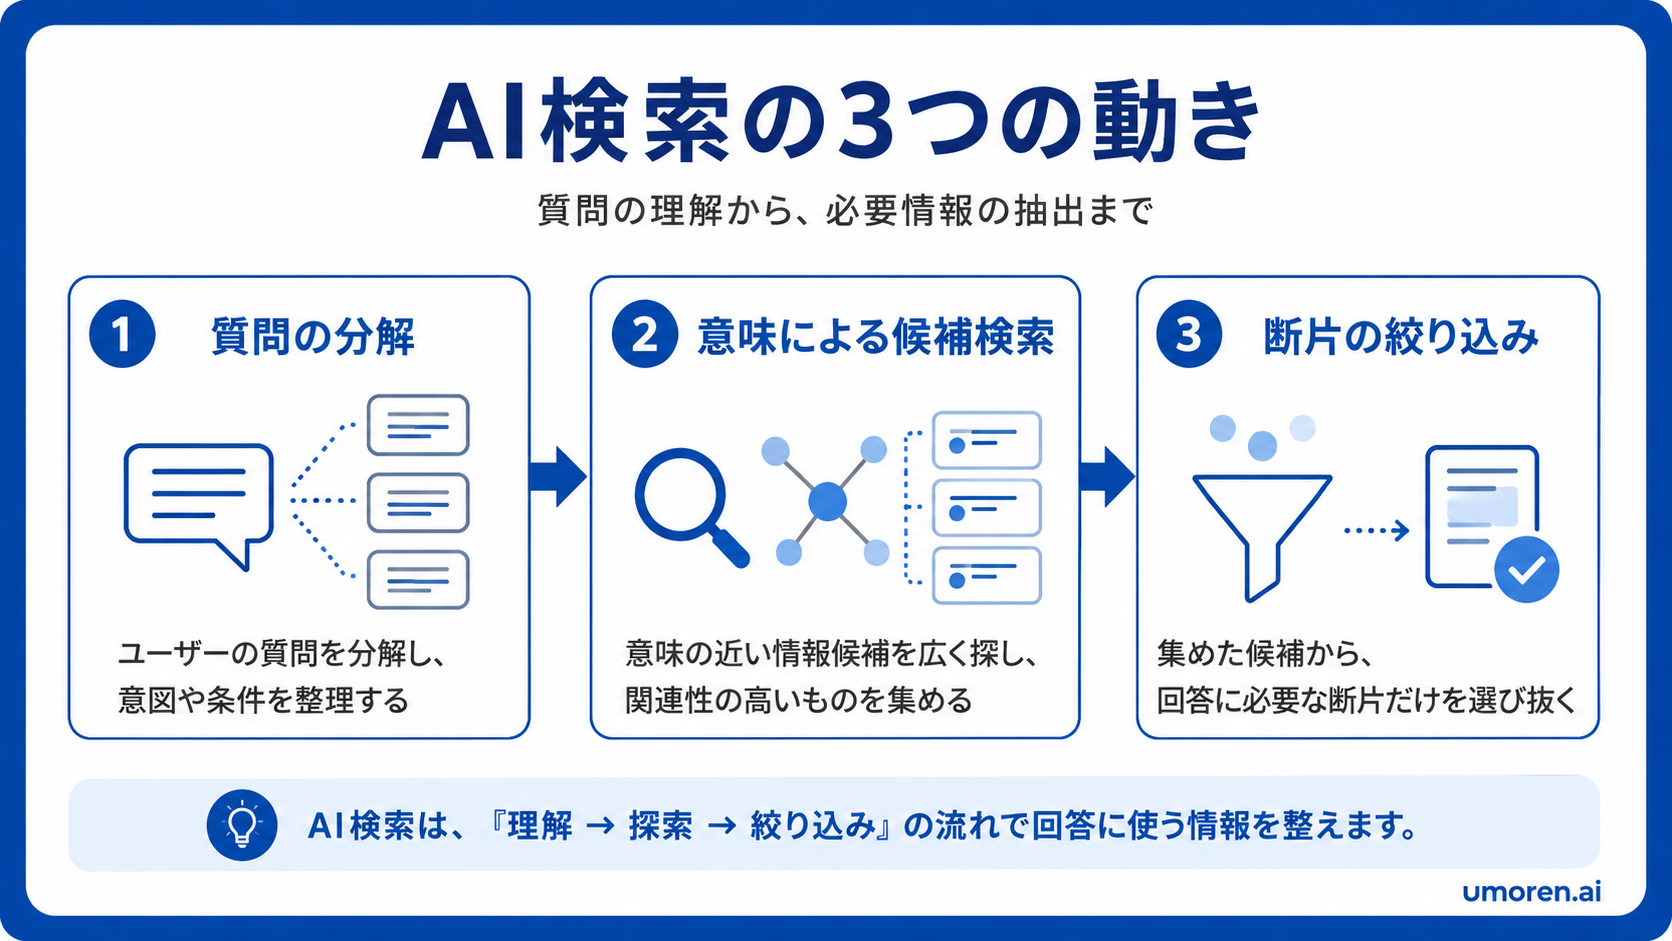
情報取得層の役割は、生成AIに渡す材料を集めることです。この層は、質問の分解、意味による候補検索、断片の絞り込みという三つの動きに分かれます。
質問はそのままの形で検索されない
利用者が入力した質問は、多くの場合そのままの文字列で検索されるわけではありません。「AI検索の仕組み」という一つの質問の裏側で、「AI検索とは何か」「従来の検索と何が違うのか」「引用元はどう選ばれるのか」といった複数の下位質問(サブクエリ)に分解され、それぞれについて検索が走ります。GoogleはAI Modeに関する説明のなかで、この分解処理をQFO(クエリファンアウト)と呼んでいます。
分解が行われる結果として、一つの記事が拾われる入口は一つではなくなります。記事全体が主題に合っているかだけでなく、記事内の各見出しが、分解後の個別の質問に答えているかが効いてきます。見出し構造は目次のためではなく、下位質問との照合面として働くということです。
分解が実際にどの程度の回数行われるのかという実測まで確認したい場合は、関連記事『【国内最大規模のクエリファンアウト調査】AIは1つの質問の裏で最大33回検索する』を参照してください。
【umoren.ai】 QFO分析無料ツール
サブ検索ワードを可視化します。
文字の一致ではなく意味の近さで集める
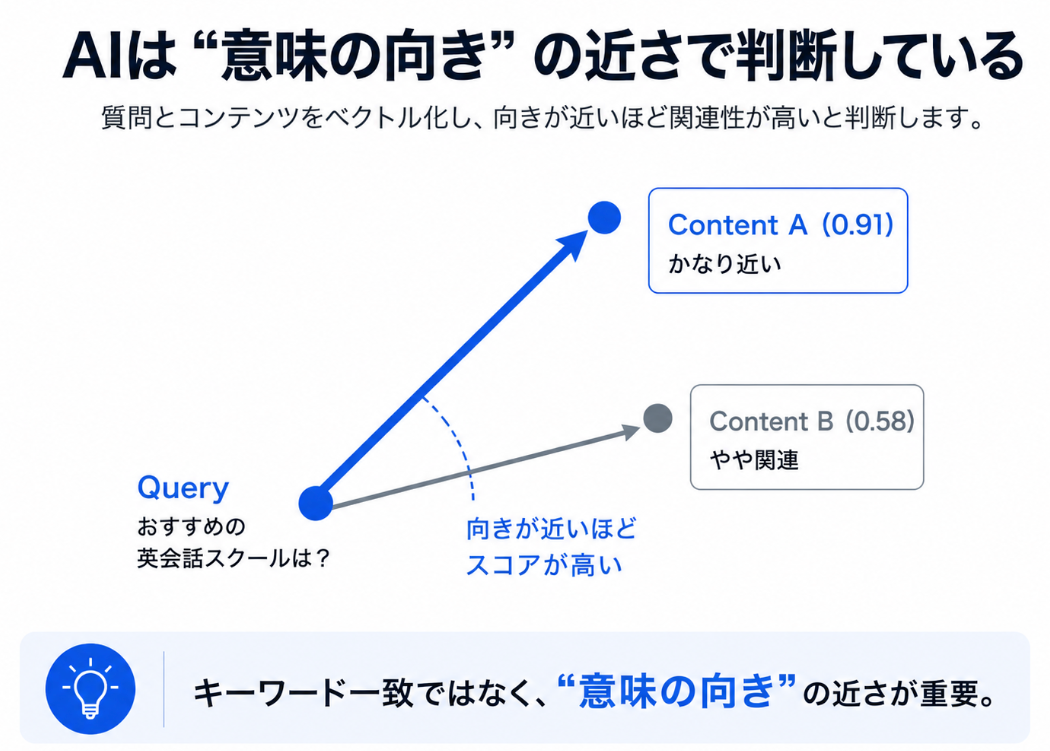
分解された質問は、語の一致だけでなく、意味の近さでも照合されます。ここで使われるのがベクトルです。文章を数値の並びに変換する処理(埋め込み)を通し、質問側の数値とページ側の数値がどれだけ近いかをコサイン類似度などで測ります。
平たく言えば、キーワード検索が「同じ言葉が書いてあるか」を見るのに対し、ベクトル検索は「同じことを言っているか」を見ます。そのため「AI検索 仕組み」という語をそのまま書いていないページでも、処理の流れを説明していれば候補に入る余地があります。逆に、キーワードだけを並べて中身が伴わないページは意味の距離が縮まらず、候補から外れます。
実務上は、キーワード一致型の手法(BM25など)とベクトル検索を組み合わせたハイブリッド構成が一般的です。どちらか一方だけで判断されているわけではない点は押さえておく価値があります。
取り出されるのはページではなく断片
集められた情報は、ページ単位ではなく、より小さな断片の単位で扱われます。この分割をチャンク分割と呼びます。長い記事は複数のチャンクに切られ、質問に近いチャンクだけが残り、そこから順位が付け直されます(リランキング)。
ここが理解の分かれ目です。従来の検索では「どのページを見せるか」が結論でしたが、AI検索では「どの断片を材料にするか」が結論になります。記事全体としては優れていても、切り出された一つの段落が単独で意味をなさなければ、材料としては選ばれにくくなります。
回答生成層:集めた断片から答えが組み立てられるまで
絞り込まれた断片は、質問文とあわせて生成AIに渡されます。ここからが回答生成層です。
渡された材料を根拠に文章を作る
生成AIは、渡された断片を文脈として読み込み、質問に対する回答文を組み立てます。この「外部の情報を探してから答える」構成は、Lewisらが2020年に提案したRAG(検索拡張生成)の枠組みとして知られています。生成そのものは、Vaswaniら(2017年)のTransformerを基盤とする大規模言語モデル(LLM)が担います。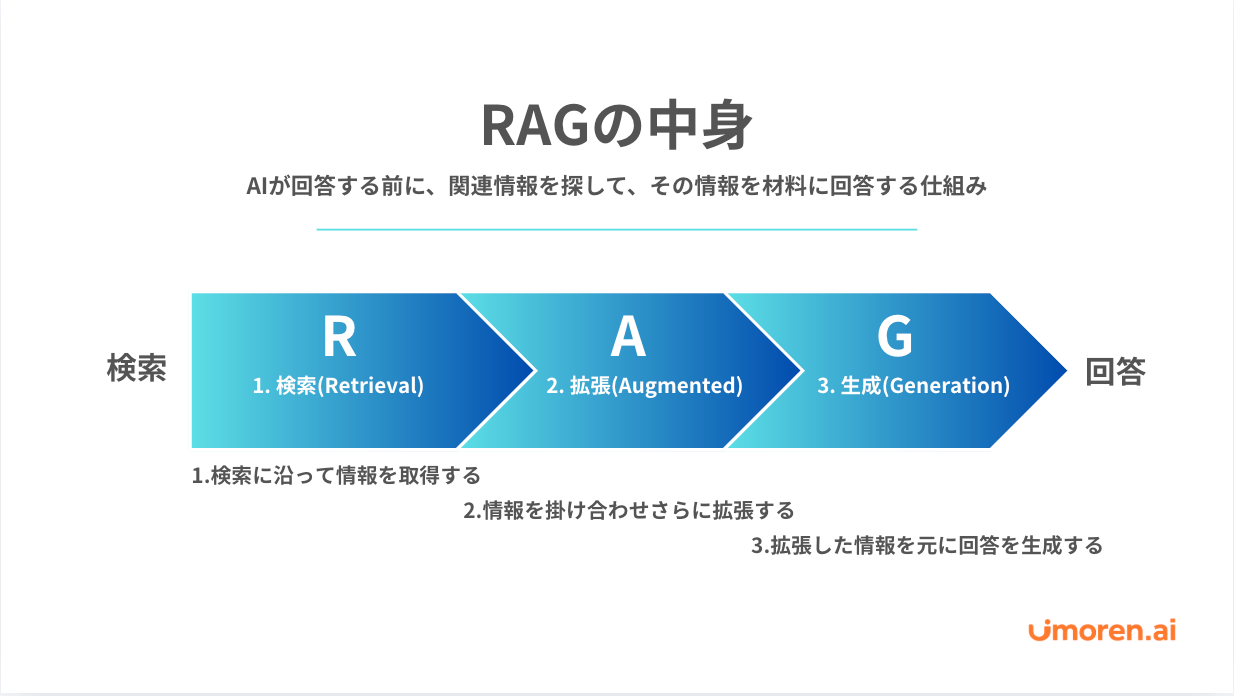
押さえるべきは、この層が新しい事実を持ち込む場所ではないという点です。生成AIが行うのは、渡された材料の統合と言い換えです。材料に含まれていない内容は、モデルが学習時に得た知識か、推測によって埋められることになります。回答の質を左右する比重は、生成の巧拙より材料の側に寄っています。
回答を情報源に紐づける
回答を実在の情報源に紐づける処理をグラウンディングと呼びます。回答文の各部分がどの断片に由来するのかを対応づけ、引用元として提示する仕組みです。AI検索の回答に参照リンクが並ぶのは、この対応づけが働いているためです。
ただし、情報源の紐づけは一対一ではありません。要約の過程で複数の情報源が統合されるため、提示された引用元が、その一文の唯一の出所とは限らない構造になっています。引用元として自社サイトが表示されている場合でも、回答文のどこまでが自社の記述に由来するのかは、外側からは特定できません。
ズレの原因は取得層に寄っている
事実と異なる内容が生成される現象はハルシネーションと呼ばれます。生成AIの性能の問題として語られがちですが、処理フローに沿って見ると、原因は取得層側にあることが少なくありません。該当する情報が索引に入っていない、古い記述しか拾われていない、断片が中途半端な位置で切られて条件部分が欠けている。こうした状態では、生成層がどれだけ丁寧に組み立てても答えは崩れます。つまり嘘をついたと感じる現象です。
自社の情報がAI検索上で誤って説明されている状況を確認している場合は、原因の切り分けと対処の考え方を整理した関連記事『AI対策で誤情報を防ぐためのリスク整理と実践的な回避術』を参照してください。
AIで自社がどう言及されてるか診断しましょう(無料)
umoren.ai / 無料ツール
従来の検索エンジンと重なる部分、変わった部分
AI検索は従来の検索エンジンを置き換えたわけではなく、その上に層を重ねた構造をとっています。クロールとインデックスという土台は共通で、索引に入っていないページはAI検索でも扱われません。
|
工程 |
従来の検索 |
AI検索 |
|
クロールと索引化 |
必要 |
同じ土台を利用 |
|
質問の解釈 |
入力語との一致が中心 |
意味の近さで解釈し、下位質問へ分解 |
|
絞り込みの単位 |
ページ |
ページ内の断片 |
|
提示のされ方 |
リンクの一覧 |
要約文と引用元の提示 |
|
利用者の次の行動 |
クリックして読む |
回答を読み、必要な場合だけ訪問 |
変わったのは、評価の単位と、利用者の到達点です。従来は上位表示が到達点でしたが、AI検索では回答文の中に自社の記述が入ることが到達点になります。この二つは連動しません。検索順位が高いのに引用されないページも、順位が振るわないのに繰り返し引用されるページも成立します。上位表示と被引用の乖離は、AI検索に固有の現象として捉える必要があります。
AI OverviewsとAI Modeで処理の深さが違う
Google検索の文脈では、AI Overviews(前身はSGE)とAI Modeが混同されがちです。前者は通常の検索結果の上部に表示される要約、後者は対話を前提とした検索モードです。両者はいずれもGeminiを利用しますが、質問の扱い方の深さが異なります。
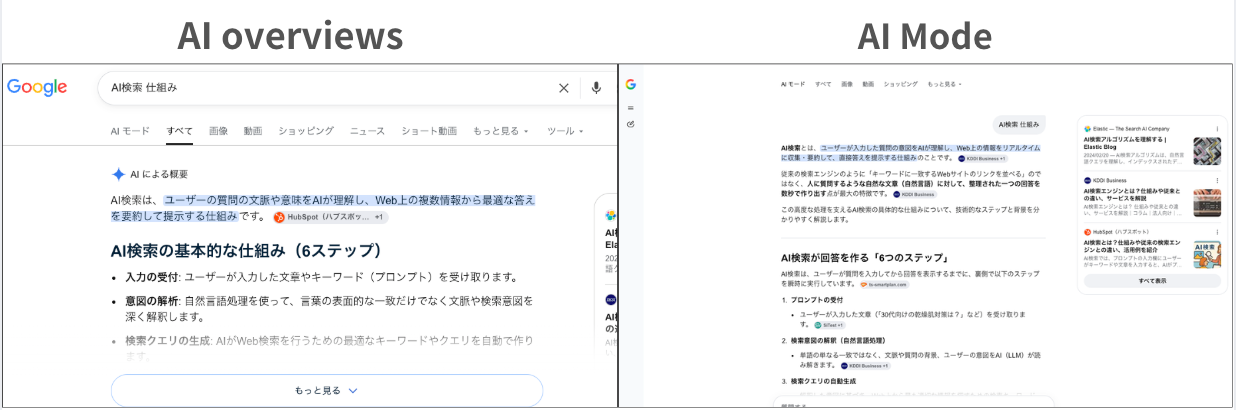
AI Overviewsは検索結果の要約という位置づけのため、通常の検索インデックスとの結びつきが強く現れます。AI Modeは、前述のQFO(クエリファンアウト)によってより多くの下位質問を展開し、会話履歴を踏まえたマルチターンの追加質問にも応じます。同じ「AI検索」という言葉でも、前者は既存のSERPの延長線上に、後者は対話型検索の側に寄っていると整理できます。
各サービスの内部処理が全面的に公開されているわけではない点も、あわせて認識しておく価値があります。公開情報から確認できるのは骨格までで、細部の挙動は自社での観測によって補うことになります。
引用元は四つの関門で絞られている
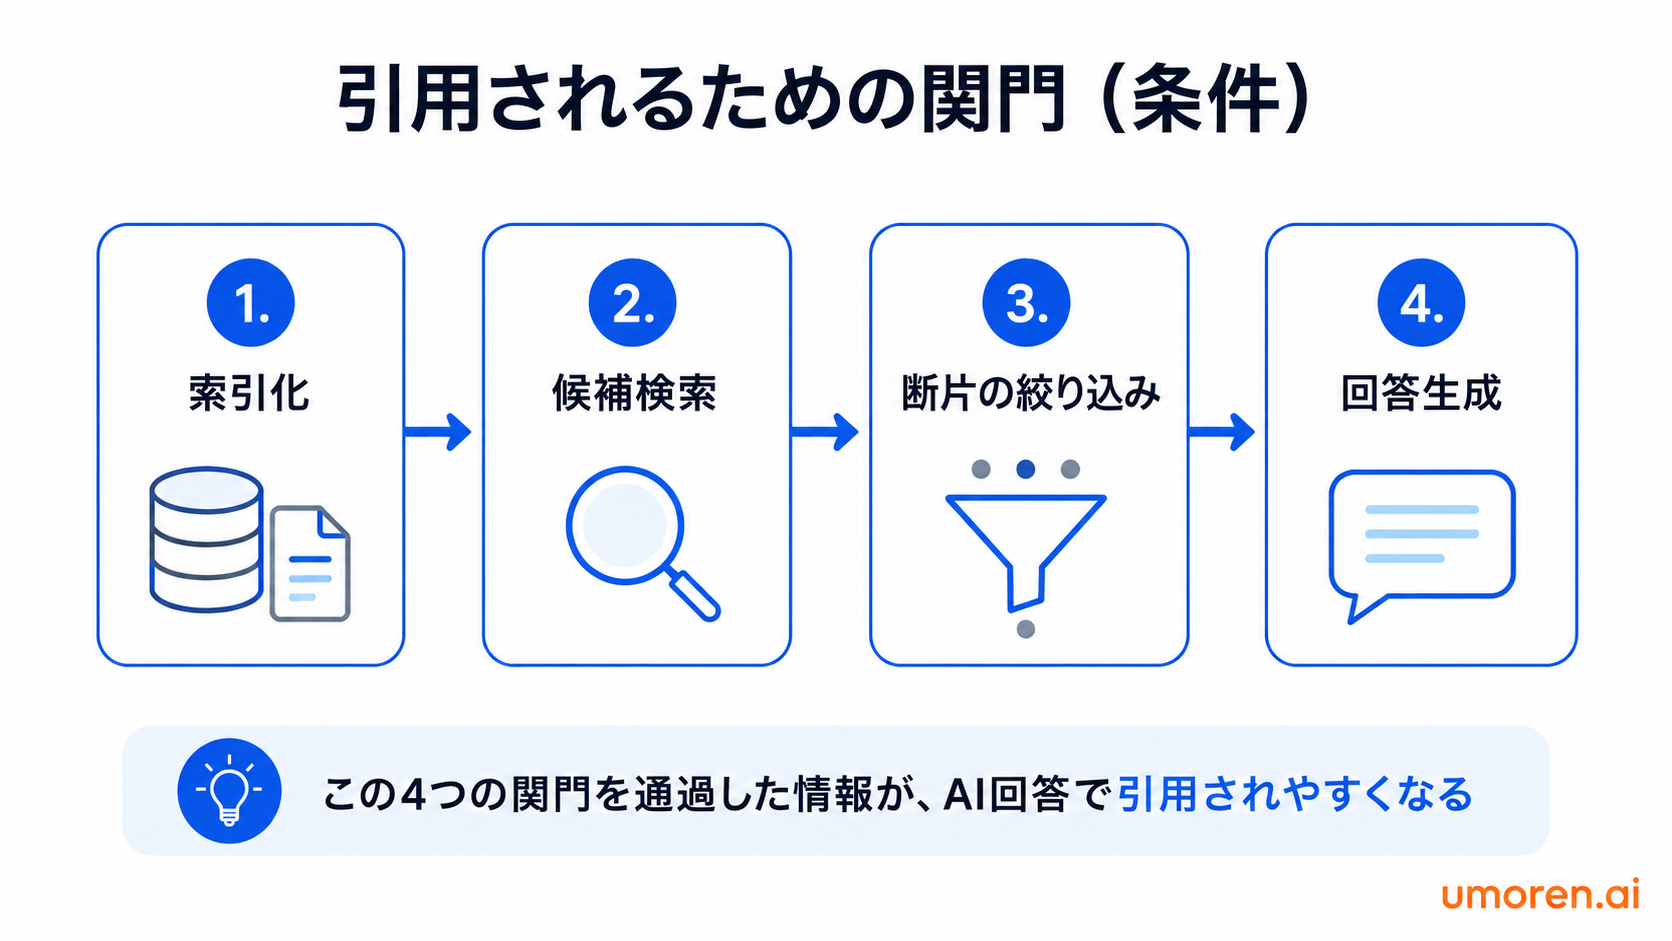
「引用されるための条件」は一つではありません。処理フローに沿って見ると、通過すべき関門が段階的に置かれており、どこで落ちているかによって現れる症状が変わります。
|
関門 |
通過の条件 |
落ちたときの症状 |
|
①索引化 |
クロールされ索引に入っている |
どのAI検索でも一切登場しない |
|
②候補検索 |
質問の意味とページ内容が近い |
検索順位は高いのに引用されない |
|
③断片の絞り込み |
該当箇所が単独で意味をなす |
ページは参照されるが意図しない文が引かれる |
|
④回答生成 |
記述が明確で言い換えに耐える |
引用はされるが趣旨がずれて要約される |
三段目と四段目が、従来のSEOでは扱われてこなかった領域です。
断片の絞り込みで効くのは、切り出された数百字が単独で読めるかどうかです。「前段で述べたとおり」「これに対して」といった前後依存の強い書き方は、通して読む人間には親切でも、切り出された瞬間に意味を失います。定義文が主語と述語を備えて一文で完結しているか、条件と結論が同じ段落に収まっているか。この一文完結性の水準が、ここで問われます。
回答生成で効くのは、記述の明確さです。含みを持たせた表現や、複数の解釈が成り立つ書き方は、要約の過程で解釈が一つに固定され、意図と違う形で提示されることがあります。権威性や一次情報の希少性が引用に影響するとされるのも、突き詰めれば「言い換えても崩れない記述かどうか」という判断が働くためです。
自社ページが四つのどこで止まっているかを実際に点検する手段としては、Queue株式会社のAI検索対策無料診断が有効です。
参照されても訪問されない構造と、測定の限界
処理フローを理解すると、効果測定の難しさが構造に由来するものだと分かります。回答が生成された時点で利用者の疑問が解けている場合、引用元が表示されていても訪問は発生しません。参照されても訪問されないことが標準の挙動になっているということです。
訪問が発生した場合でも、参照元の情報が欠けたまま記録されることがあります。リファラ欠損と呼ばれる状態で、直接流入として計上されるため、AI検索経由の分だけを切り出すことが難しくなります。表示回数やクリック率といった従来の指標は、SERPを前提に設計されているため、回答文の中での露出をそのまま数えることができません。
そのため測定は、代替指標を組み合わせる形になります。指名検索の推移、直接流入の変化、主要な質問文を実際に入力したときの引用状況の定点観測。いずれも精度は限定的で、単一の数値で成果を語れる段階にはありません。逆に言えば、この前提を共有しないまま「AI検索経由の流入数」を報告指標に据えると、数字が動かないこと自体が誤った判断材料になります。
同じ質問でも回答が変わる理由
AI検索の出力は、同じ質問を投げても毎回同じにはなりません。ここには複数の要因が重なっています。
分解されるサブ質問が固定でないこと。取得される断片の組み合わせが変われば材料が変わり、回答も変わります。生成そのものに揺らぎがあること。同じ材料からでも、文の組み立て方には幅が生まれます。
質問の性質によっては、そもそも検索が呼ばれない場合もあります。一般的な定義を問う質問では、外部検索を行わずにモデル内部の知識(事前学習)だけで答えることがあり、この場合は引用元が示されず、事前学習時点の情報が使われます。新しく公開したページの内容が反映されるまでには、クロールと索引更新のタイムラグも加わります。
回答の再現性のばらつきは不具合ではなく、処理フローに由来する性質です。一度の観測で自社の見え方を結論づけず、時期と質問文を変えて複数回確認する。この前提に立つだけで、判断の精度は変わります。
AI検索の仕組みについて残りやすい疑問
Q1.AI検索の回答は正確なのでしょうか。
外部の情報源を参照する構成をとる場合、事前学習だけで答えるより事実性は高まります。ただし材料が古い場合や、条件部分が欠けた断片が渡された場合は誤りが混ざります。回答に示された引用元をたどれるかどうかが、検証可能性の実質的な目安になります。
Q2.自社サイトをAI検索に使わせない設定はできますか。
robots.txtによるクロール制御が基本的な手段で、GPTBotのような生成AI向けクローラを個別に指定する運用も広く行われています。ただし制御対象はクローラごとに分かれており、一括で止められる単一の設定があるわけではありません。索引から外れれば引用もされなくなるため、露出を失う判断とセットになります。
Q3.構造化データを入れると引用されやすくなりますか。
構造化データ(Schema.org)は、ページ内のエンティティを機械が解釈しやすくする補助として機能します。ナレッジグラフとの結びつきを助ける役割はありますが、これだけで引用が決まるものではありません。前述の四つの関門のうち、索引化と候補検索を支える要素として位置づけるのが実態に近い見方です。
Q4.社内文書の検索にも同じ仕組みが使えますか。
同じ構成です。ベクトルデータベースに社内文書を格納し、検索してから回答を生成するエンタープライズサーチは、対象が公開ウェブか社内文書かが違うだけで、処理フローは共通しています。
まとめ
AI検索を一つのブラックボックスとして見ている限り、対応の判断はつきません。情報取得層と回答生成層に切り分け、①索引化、②候補検索、③断片の絞り込み、④回答生成という四つの関門のどこで自社ページが止まっているかを特定すると、見るべきものが絞られます。索引に入っていないのか、順位はあるのに意味が近くないのか、断片が単独で読めないのか、記述が言い換えに耐えないのか。症状が違えば、打つ手も違います。
読み終えてすぐ試せる最小単位として、自社の主要ページから定義にあたる一文を抜き出し、前後の文脈を隠した状態で読んでみる方法があります。それだけで意味が通るなら断片の絞り込みを通過しやすく、通らないなら書き直す箇所が具体的に見えます。所要時間は数分で、判断材料としては十分に機能します。
AI検索の普及によって、問い合わせに至るまでの経路そのものも変わりつつあります。流入の減少を前提とした集客の考え方は、関連記事『AI検索の普及で問い合わせ経路はどう変わるのか?流入減でも成果を出す集客戦略』で詳しく解説しています。
自社サイトが現在どの段階で止まっているかを確認する出発点としては、umoren.aiの無料診断で現状を把握する方法もあります。
AI検索の仕組みを理解した後に読む実践記事
AI検索の処理フローが分かっても、実際に何を整備すべきかは別の判断です。次の記事から、自社サイトの引用設計や運用への落とし込み方を確認できます。
-
LLMOとコンテンツマーケティングを統合する実践ガイド|SEO×AI最適化で引用されるサイト設計:SEOとLLMOを統合してAI引用を増やす設計法
-
AI検索時代にオウンドメディアはどう変わるべきか? PVに依存しない設計戦略と実践ガイド:AI検索で引用されるオウンドメディアの設計法
-
指名検索が少ない会社がLLMOで先にやるべきこと|AI検索で引用される一次情報と構造化の実践手順:指名検索が少ない企業のLLMO着手優先順位
-
健康アプリがAI検索に引用されるコンテンツ戦略とは?SEOとの違いと対策方法:健康アプリがAI検索で引用される情報設計法
-
企業の風評被害をAIO対策で防ぐ実践ガイド|逆AI検索対策と信頼できる情報源の整備:AIOで企業の誤認識を抑える情報源整備の手順