

AIエージェントと通常のチャットAIは何が違うのか。目標に対する計画、外部ツールの利用、実行結果の確認という制御ループの仕組みから、両者の本質的な違いと導入時の注意点までを解説します。
AIエージェントという言葉を耳にする機会が増えましたが、通常のチャットAIと何が違うのか、どのような業務に向いているのかは分かりにくいものです。どちらもLLMを利用する一方、目標に到達するまでの動き方が異なります。
通常のチャットAIは入力に対して回答を生成し、AIエージェントは目標に対して計画、実行、観測、再計画を繰り返します。
本記事では、1回の指示に対して回答を返す対話型の使い方を「通常のチャットAI」と呼びます。そのうえで、AIエージェントの構造、計画・ツール利用・実行結果の確認がつながる仕組み、LLMとRAGの役割、導入時の注意点を解説します。
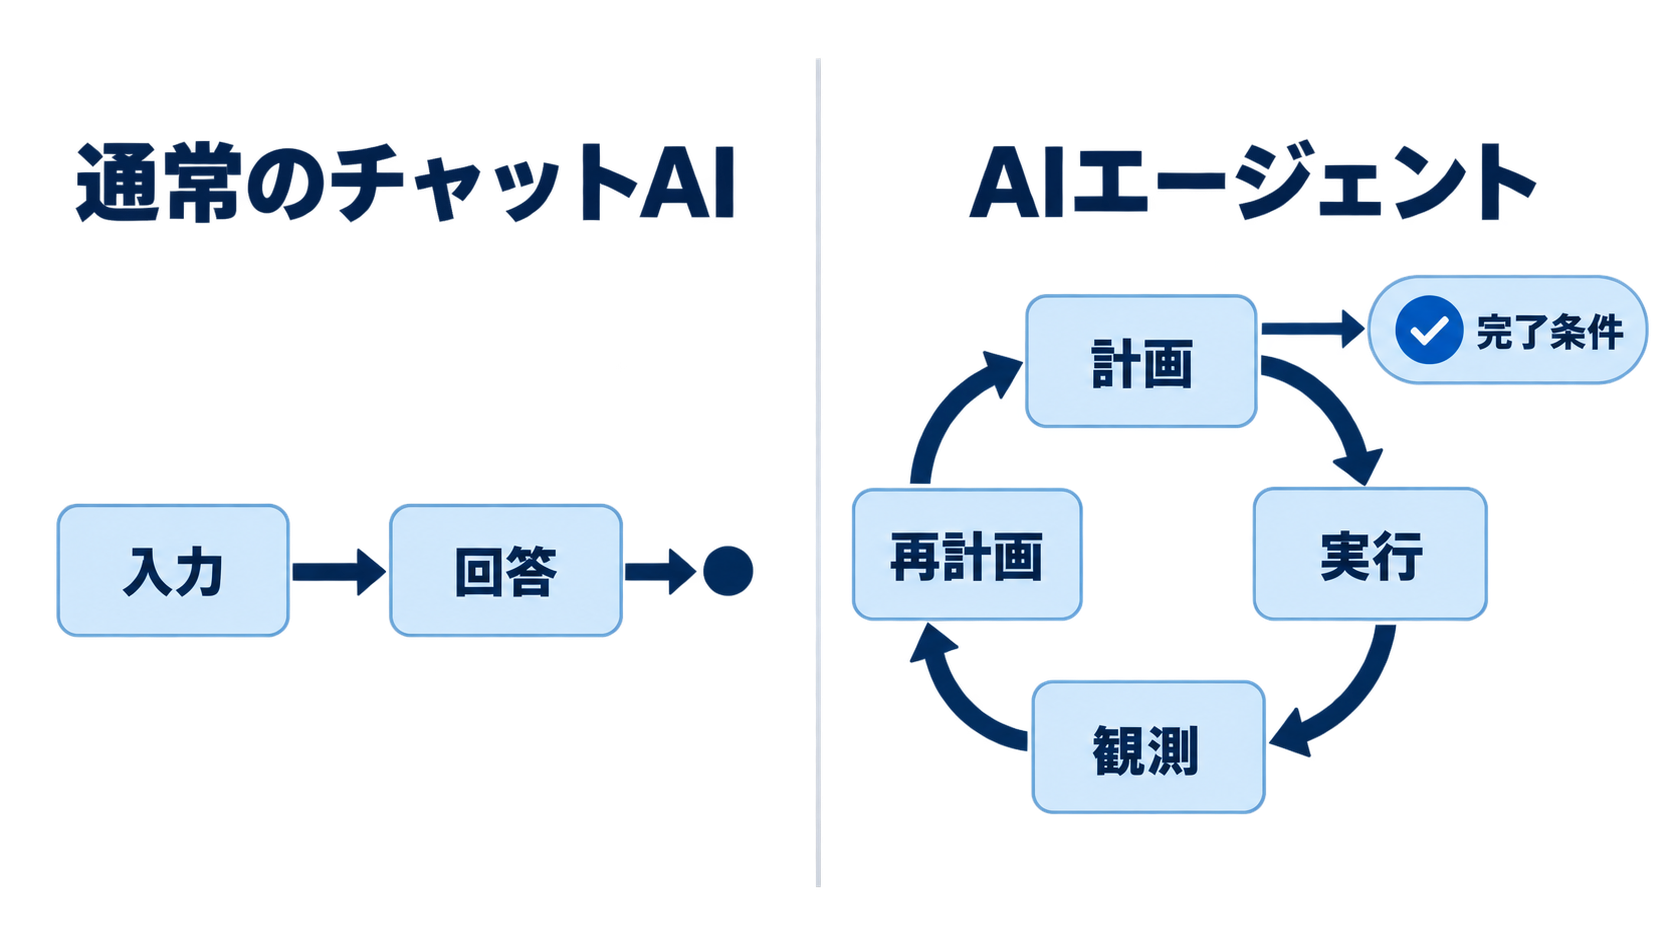
たとえば「競合3社の料金ページを調べて比較表にまとめる」という依頼では、通常のチャットAIは学習済みの知識から比較表の形を出力します。AIエージェントは調査対象を確定し、検索ツールで各社のページを取得します。取得できないページがあれば別の手段を試し、最後に比較表を生成します。同じ依頼でも、動く範囲と成果物の性質が異なります。
通常のチャットAIとAIエージェントの違い
AIエージェントは、人間から与えられた目標に対して計画を立て、外部ツールを実行し、その結果を確認しながら次の行動を決めるシステムです。通常のチャットAIが1回の入出力で完結するのに対し、AIエージェントは完了条件を満たすまで複数のステップを繰り返します。
AIエージェント
AIエージェントとは、目標の達成に向けて計画、ツール実行、観測、再計画を繰り返すシステムです。
回答する仕組みと実行する仕組み
通常のチャットAIは「受動的な出力装置」、AIエージェントは「能動的な実行主体」と整理できます。前者では人間が次の操作を決めます。後者では、システムが観測結果をもとに次の行動を選びます。
|
比較軸 |
通常のチャットAI |
AIエージェント |
|---|---|---|
|
入力の単位 |
1回の質問・指示 |
達成すべき目標(ゴール) |
|
内部の処理 |
プロンプト→トークン生成→出力 |
計画→ツール実行→観測→再計画のループ |
|
外部への働きかけ |
原則なし(テキスト出力のみ) |
検索API・データベース・CRMなどを呼び出す |
|
失敗したとき |
人間が指示し直す |
原因を特定し、自ら手段を変えて再試行 |
|
状態の保持 |
会話履歴の範囲 |
タスクの進捗・中間成果物を保持 |
|
終了の決まり方 |
1回の回答を返した時点 |
完了条件の充足、または停止条件の発動 |
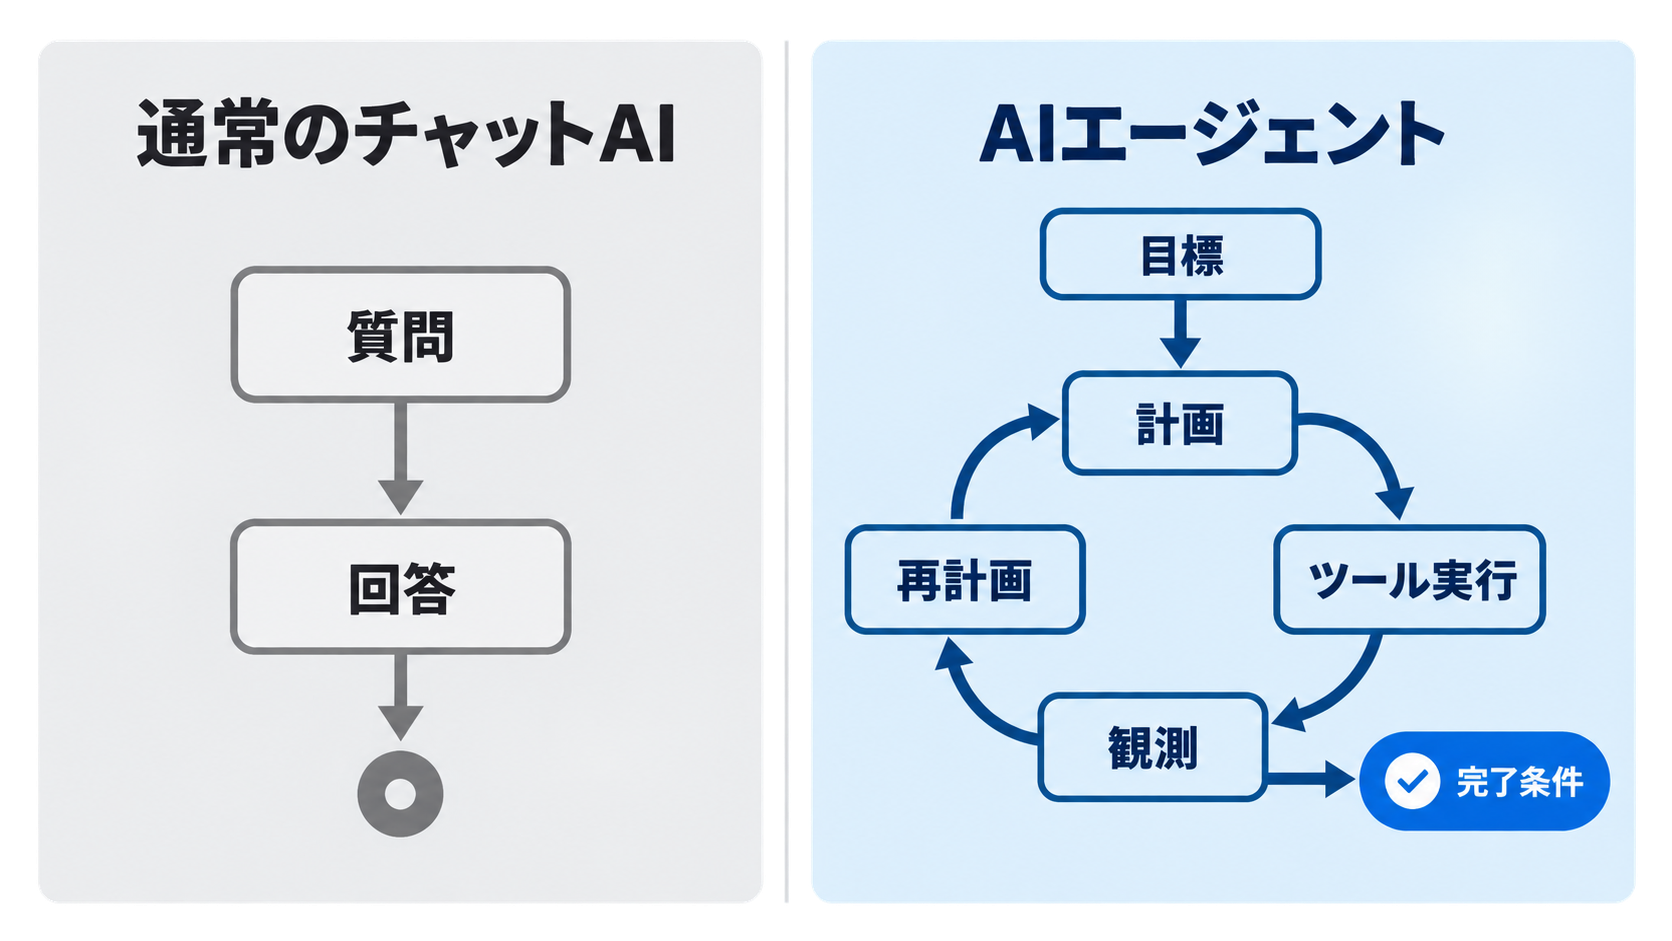
「トークン」とは、AIが文章を処理するときの最小単位となる文字列です。通常のチャットAIはトークンを順に予測して1つの回答を完成させ、処理を終えます。
高性能なチャットボットとの違い
AIエージェントとチャットボットの差は、モデルの性能だけではなく、システムの構造にあります。同じLLMを使っても、外部ツールとの接続や実行結果を受け取るループがなければ、エージェントとしては動きません。
構造の差は、次の5点に整理できます。
-
自律性:次の行動を人間が指示するか、システムが決めるか
-
目標指向:1回の回答が目的か、目標の達成が目的か
-
環境への働きかけ:テキストを返すだけか、APIを実行して状態を変えるか
-
状態の永続性:会話が終われば消えるか、タスクの進捗を保持するか
-
停止条件:回答生成で終わるか、条件を定義して止める必要があるか
停止条件を設計しないと、エージェントが同じ処理を繰り返す可能性があります。
LLMとエージェント基盤の役割
LLM(Large Language Model/大規模言語モデル)は判断する頭脳を担い、エージェント基盤はその判断を実行へつなげてループを制御します。LLM単体では、外部情報の取得や業務システムの操作までは行えません。
LLMとエージェント
LLMは目標や結果を解釈し、エージェント基盤はツール実行、履歴管理、ループ制御を担います。
RAGとAIエージェントの違い
RAG(Retrieval-Augmented Generation/検索拡張生成)は、外部情報を検索し、その情報を根拠に回答を生成する仕組みです。RAGが回答の根拠を補う技術であるのに対し、AIエージェントはRAGを含む複数のツールを使い分けて目標達成を目指します。
RAGとAIエージェント
RAGは検索した情報を回答の根拠にする仕組みであり、AIエージェントでは目標達成のために使う部品の1つです。
-
RAG:検索→取得→生成の流れが基本は1回で、目的は回答精度の向上
-
AIエージェント:検索は手段の1つで、取得結果を評価し、不足があれば再検索や別ツールへ切り替える
-
両者の関係:AIエージェントの内部でRAGが部品として動くことが多い
情報取得から回答生成までの流れは、RAGとAI検索の関係を整理した解説とAI検索の処理フローの図解で詳しく説明しています。
計画 ツール利用 実行結果の確認のつながり
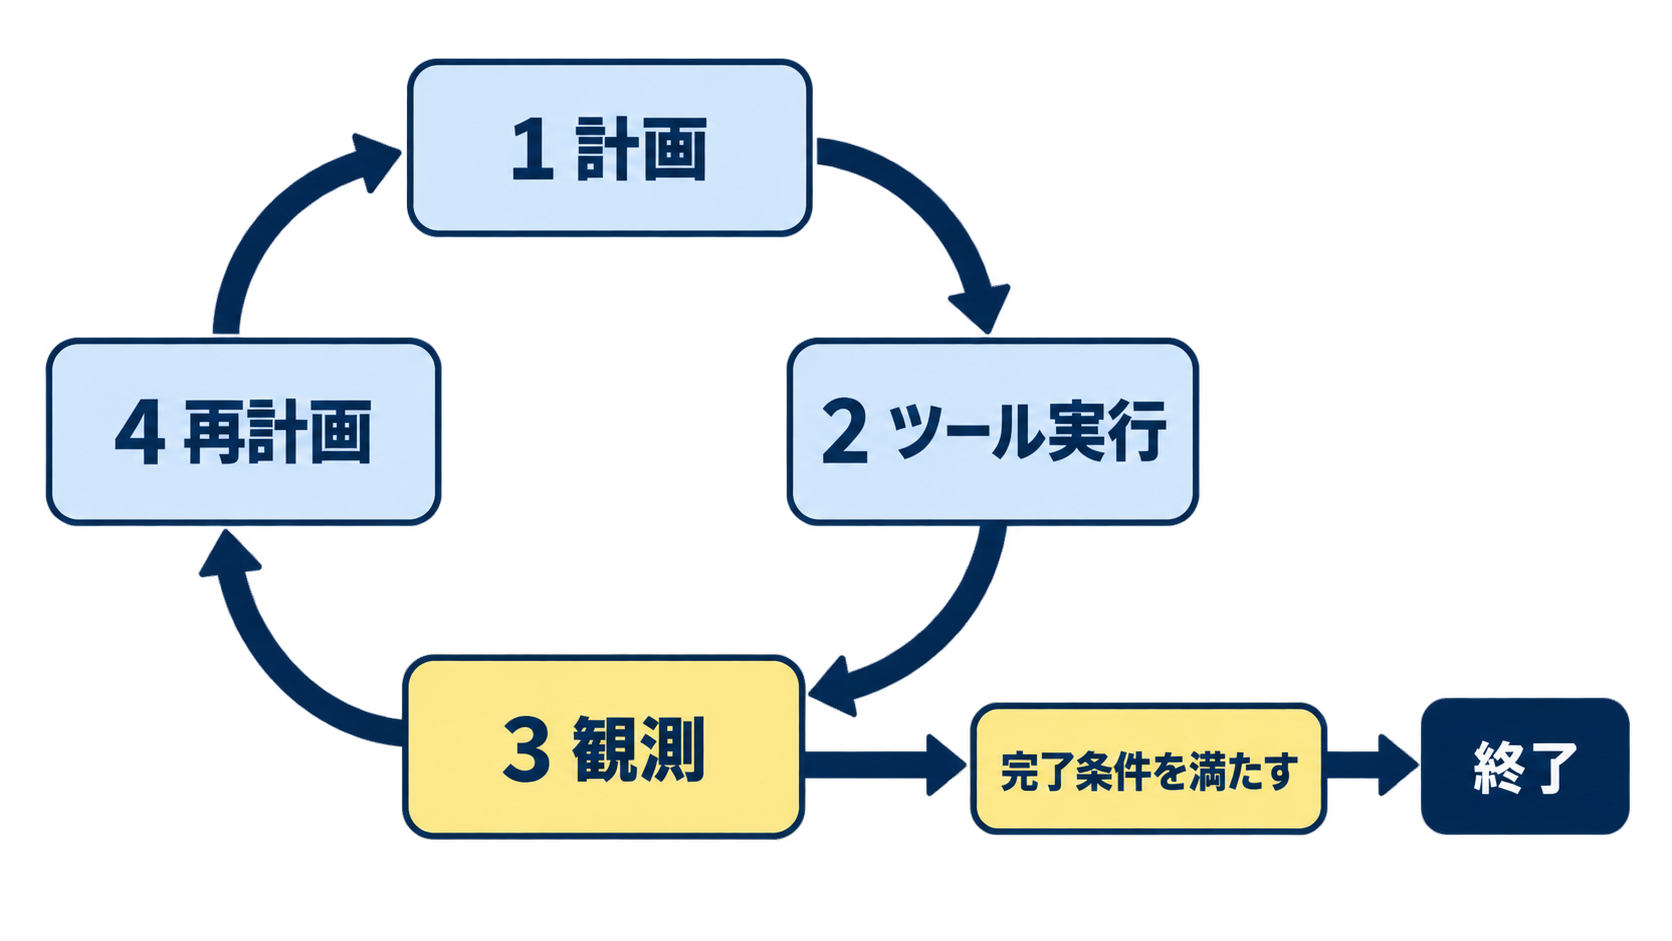
計画、ツール利用、実行結果の確認は、独立した工程ではありません。「計画→実行→観測→再計画」という1つの制御ループをつくります。観測結果が完了条件を満たさなければ、計画へ戻って別の手段を選びます。
本記事では、AIエージェントの動作を実際の処理順に沿って、次の4つに分けます。
-
計画(Planning)
-
ツール利用(Tool Use)
-
実行結果の確認(Observation / Reflection)
-
再計画と停止条件
計画で完了条件と実行順序を決める
計画とは、大きな目標を実行可能なタスクへ分解し、実行順序を決める工程です。ここで完了条件を定義しなければ、後の観測で目標を達成したか判断できません。
Queue株式会社では、目標を「完了条件・制約・必要情報」に整理し、依存関係と優先度から実行順序を決める設計を採用しています。たとえば市場調査では、最初に調査対象と評価基準を確定し、その後に情報収集、分析、検証、レポート作成へ進みます。
-
完了条件:何が揃えば目標達成とみなすか。例として、比較表に3社分の料金と提供形態が埋まっている状態
-
制約:使ってよい情報源、コスト上限、実行してよい操作の範囲
-
必要情報:目標達成に不足している情報の一覧
-
実行順序:後続タスクが前の結果を必要とするかという依存関係と優先度
ツール利用で外部の情報や機能を呼び出す
ツール利用とは、計画の各ステップを実行するために、AIが外部機能を選んで呼び出すことです。LLMが使う関数名と引数を出力し、エージェント基盤が実際の処理を行います。
Function Calling(関数呼び出し)では、AIが「どのツールを、どの引数で実行するか」を構造化データとして返します。APIを実行するのはアプリケーション側です。この分離により、実行前に権限チェックや人間の承認を挟めます。
Function Calling
Function Callingとは、AIがツール名と引数を構造化して返し、アプリケーションがその内容に沿って処理を実行する仕組みです。
Queue株式会社では、ツールの機能定義に加えて、次の6観点で接続先を比較します。
最新情報には検索API、社内情報にはデータベース、顧客対応にはCRMを選び、取得結果をLLMへ戻して次の判断につなげます。
|
観点 |
判断の内容 |
例 |
|---|---|---|
|
目的への適合度 |
そのツールで目標に近づくか |
社内の受注実績は検索APIでは取得できない |
|
データの鮮度 |
情報が現時点のものか |
当日の在庫は学習済み知識では答えられない |
|
精度 |
返却値の信頼度 |
一次情報のデータベースを優先 |
|
処理速度 |
応答にかかる時間 |
大量取得は分割して実行 |
|
コスト |
API課金・トークン消費 |
同一データの重複取得を避ける |
|
権限 |
実行が許可された操作か |
書き込み系は承認を必須にする |
実行結果の確認で達成度を評価する
実行結果の確認では、ツールの返却値やエラーを観測し、計画時に定義した完了条件と照合します。この工程がなければ、AIは「処理を実行した」ことと「目標を達成した」ことを区別できません。
Queue株式会社では、返却値、ステータス、実行ログを観測して目標到達度を評価します。たとえばデータ登録では、APIの成功応答だけで完了としません。登録後のデータを再取得し、必須項目と内容を検証します。条件を満たさない場合は原因を特定し、修正して再実行します。
制御ループの実行例
以下は「顧客マスタに新規取引先を登録する」タスクの実行例です。
担当者名が不足してエラーになった後、取得元を見積書へ変えて再試行しています。
[1] 計画 : 完了条件=顧客IDが発行され、会社名・住所・担当者が登録済み
手順=(1)重複確認 (2)登録API実行 (3)登録内容の再取得検証
[2] ツール : search_customer(name="○○商事") → 該当0件
[3] 観測 : 重複なし。手順(2)へ進行可能と判定
[4] ツール : create_customer(name="○○商事", address="...", contact=null)
[5] 観測 : HTTP 400 / error="contact is required"
[6] 再計画 : 担当者名が未取得。取得元を見積書PDFへ変更して手順を1つ追加
[7] ツール : extract_document(file="mitsumori.pdf", field="担当者") → "田中"
[8] ツール : create_customer(..., contact="田中") → HTTP 201 / id=10482
[9] 観測 : 成功応答を受領。ただし完了条件未確認のため検証を実行
[10] ツール : get_customer(id=10482) → 会社名・住所・担当者すべて登録済み
[11] 判定 : 完了条件を充足。ループ終了
注目すべき点は[5]と[9]です。[5]ではエラーで止まらず、不足情報の取得元を変えて計画を修正しています。[9]では成功応答だけで終了せず、登録データを再取得して完了条件と照合しています。この2つの挙動が、単発の回答生成との構造的な違いです。
推論と行動を交互に行うループは「ReAct(Reasoning and Acting)」と呼ばれます。
失敗の原因を言語化し、次の試行に反映する設計は「Reflexion(自己修正)」として知られています。
停止条件でループを安全に終える
停止条件は、エージェントがループを終える基準です。エージェントは自分で止まる基準を持たない限り動き続けるため、設計段階で終了条件を決める必要があります。
-
成功停止:完了条件を満たした時点で終了
-
試行回数上限:同一タスクの再試行を一定回数で打ち切る
-
コスト上限:トークン消費やAPI課金が閾値を超えたら終了
-
人間への引き継ぎ:判断がつかない場合に処理を止めて確認を求める
AIエージェント導入時の注意点と限界
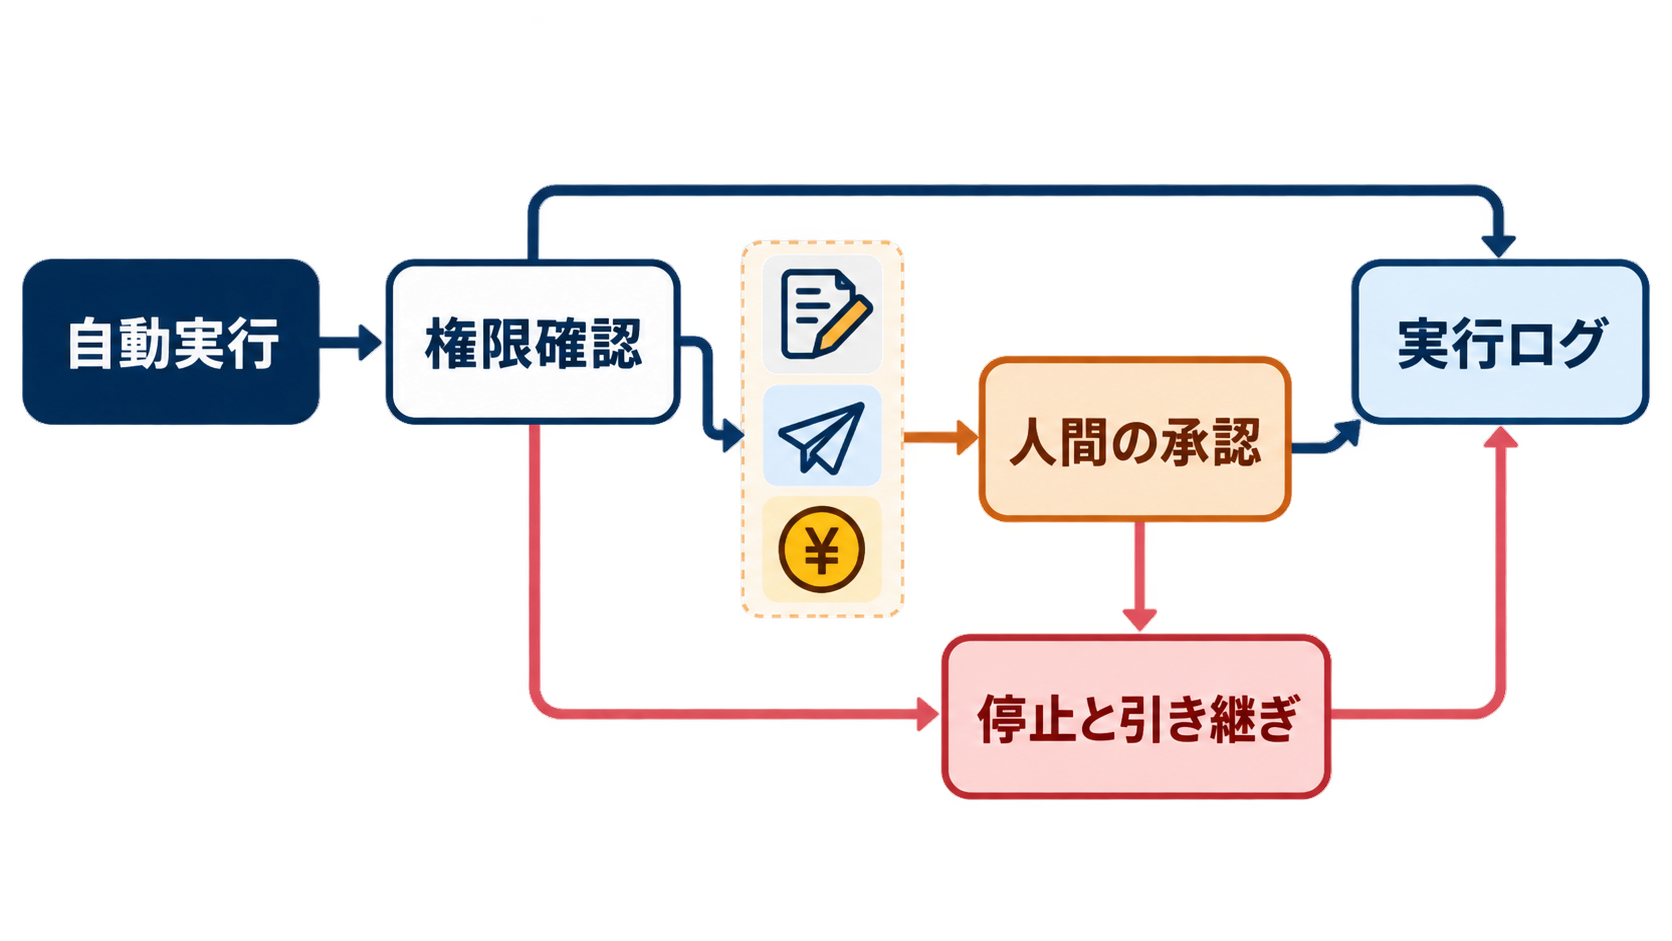
AIエージェントは外部システムを操作するため、誤った実行がデータやコストへ直接影響します。導入時は、権限の範囲、停止条件、人間の承認ポイントを先に設計する必要があります。
セキュリティとプライバシーの対策
基本は、エージェントに与える権限を絞り、実行できる操作を限定することです。接続したツールの範囲は、そのままエージェントが実行できる操作の範囲になります。
-
読み取りと書き込みの分離:参照系と更新系で権限を分け、更新系は承認を必須にする
-
データの持ち出し範囲:顧客情報や個人情報を外部APIへ渡さない設計にする
-
プロンプトインジェクション対策:外部から取得した文章に紛れた指示を、実行指示として扱わない
-
実行ログの保全:どのツールをどの引数で呼んだかを記録し、後から追跡できるようにする
無限ループと意図しない実行を防ぐガードレール
|
失敗パターン |
発生する事象 |
設定するガードレール |
|---|---|---|
|
同じツールの反復 |
検索結果が不十分で再検索を繰り返す |
同一ツールの連続実行を回数で制限 |
|
完了判定の甘さ |
成功応答だけで終了し、データが不完全 |
完了条件との照合を必須工程にする |
|
コストの暴走 |
大量データを分割せず何度も取得 |
実行あたりのトークン・API課金の上限設定 |
|
破壊的操作 |
削除・一括更新が意図せず実行される |
更新系ツールは人間の承認を挟む |
|
権限の過剰付与 |
業務に不要なシステムへアクセス |
ツールごとに最小権限を割り当てる |
人間が担う目的設定と最終判断
エージェントは完了条件との照合はできますが、完了条件そのものが正しいかまでは判断できません。目的設定と最終判断は、人間が担う領域として残ります。
-
目的の定義:何を達成すべきか、どこまでを成果とするか
-
制約の設定:触れてよいデータ、実行してよい操作、使ってよいコスト
-
最終承認:外部への送信、金銭が動く処理、顧客に届く成果物の確認
自律実行の範囲が広いほど、確認ポイントを絞り込む設計が必要です。すべてを承認制にすると自動化の効果が薄れ、すべてを自動化するとリスクが残ります。
自社業務への導入手順
導入は、完了条件の定義から始めます。その後にツール接続、検証工程、停止条件とログを設計すると、実行と評価を一貫させやすくなります。
1. 完了条件の確定 対象業務のゴールを「何が揃えば完了か」の形に書き下す
2. ツールの棚卸しと接続 最新情報は検索API、社内情報はデータベース、顧客対応はCRMというように、情報の所在から接続先を決める
3. 検証工程の実装 成功応答だけで完了とせず、登録・更新後のデータを再取得して必須項目を照合する
4. 停止条件とログ設計 試行回数、コスト上限、人間への引き継ぎ条件を定め、実行ログを記録する
AIエージェント化が向く業務
基幹システムやCRMと連携し、実行結果の検証まで自動化したい業務には、AIエージェントが適しています。一方、既存のチャットAIへ定型の質問を投げるだけで完結する業務では、エージェント化のコストに見合わないことがあります。その場合は、プロンプト運用の整備から始めるほうが合理的です。
Queue株式会社の設計アプローチ
Queue株式会社は、目標を「完了条件・制約・必要情報」に整理してタスクを分解し、実行しただけで終わらない達成プロセスを設計します。RAG、Embedding、Tokenizer、回答生成の仕組みを理解したLLMエンジニアチームが、計画、ツール利用、実行結果の確認を設計する点が、一般的なSEO・Webマーケティング会社との違いです。
ツール選択では、目的への適合度、データの鮮度、精度、処理速度、コスト、権限の6観点を用います。Function Callingを通じてAPIやデータベースを接続し、取得結果を次の行動判断へ戻します。
Queue株式会社が提供するUmoren.aiは、AI検索最適化(LLMO / AI SEO / GEO / AIO)の領域で、診断、戦略設計、改善支援、分析改善サイクルの4つをワンストップで提供するサービスです。AI検索でどの情報が拾われているかを診断する考え方は、エージェントの情報取得設計にも通じます。
AIの裏側でどれだけ検索が発行されているかは、1800プロンプト規模のAI検索実行率調査にまとめています。サービスの詳細はQueue株式会社の公式サイトをご確認ください。
AIエージェントに関するよくある質問
計画、ツール利用、実行結果の確認をめぐり、実装段階でよく挙がる質問をまとめます。
通常のチャットAIはプロンプトの工夫で代用できますか
本記事で定義した外部ツール接続のない通常のチャットAIでは、代用できません。手順の提案はできますが、外部APIの実行、結果の観測、計画の修正は人間が担う必要があります。
実行中のタスクを人間が停止できますか
停止できます。ただし、設計時に停止条件と中断ポイントを組み込む必要があります。試行回数上限、コスト上限、人間への引き継ぎ条件を事前に定義しておくことが前提です。
制御ループはどのような環境で動きますか
LLMがツール呼び出しの内容を決め、エージェント基盤が実行、結果の差し戻し、履歴管理を行う構成で動きます。OpenAIは長時間動作するエージェントについて、ツール利用、コンテキスト管理、サブエージェントの活用を重視しており、複数ステップの実行システムとしての設計が前提になっています。コンテキストウィンドウ(一度にAIが読める情報量の上限)を超えないよう、中間成果物を要約して保持する設計が実務では必要です。
業務システムとの連携は何から始めますか
最初に対象業務の完了条件を文章化します。完了条件が曖昧なままAPIを接続しても、実行結果の検証工程を設計できません。その後、6つの比較観点を使って、どのシステムをどの順で接続するか整理します。
AI検索での情報取得を調べる方法はありますか
Queue株式会社は、RAG、Embedding、Tokenizerの仕組みを理解したLLMエンジニアチームによる診断で、AI検索における自社の露出状況を可視化します。関連する仕組みは、次の記事で解説しています。
チャットAIから自律型AIエージェントへ移行する手順
両者の違いはモデルの賢さではなく、回答生成で終わるか、計画・実行・観測・再計画のループを持つかという構造にあります。
移行の出発点は、高性能なモデルを選ぶことではありません。業務の完了条件を定義し、どこまで自動化するかを決めることです。
1. 対話利用 チャットAIで文章生成、要約、アイデア出しを行う
2. 根拠接続 RAGで社内文書や最新情報を回答の根拠にする
3. 単一タスク自動化 完了条件を定義した1業務で、ツール実行と結果検証まで自動化する
4. 業務プロセス自動化 複数タスクを依存関係でつなぎ、停止条件と承認ポイントを設計して運用する
Queue株式会社は、目標を「完了条件・制約・必要情報」に整理して実行順序を決める設計と、Umoren.aiの診断・戦略設計・改善支援・分析改善サイクルにより、通常のチャットAIとの違いを実務の成果へつなげる支援を行っています。計画、ツール利用、実行結果の確認のどこから着手すべきか判断したい場合は、Queue株式会社へご相談ください。
AI検索対策を、LLMエンジニアチームに無料相談
AI検索での自社の露出や引用に課題を感じていませんか?Umoren.aiのLLMエンジニアチームが、貴社の課題に合わせたLLMO・AIO対策を一緒に考えます。まずは30分の無料相談へ。