

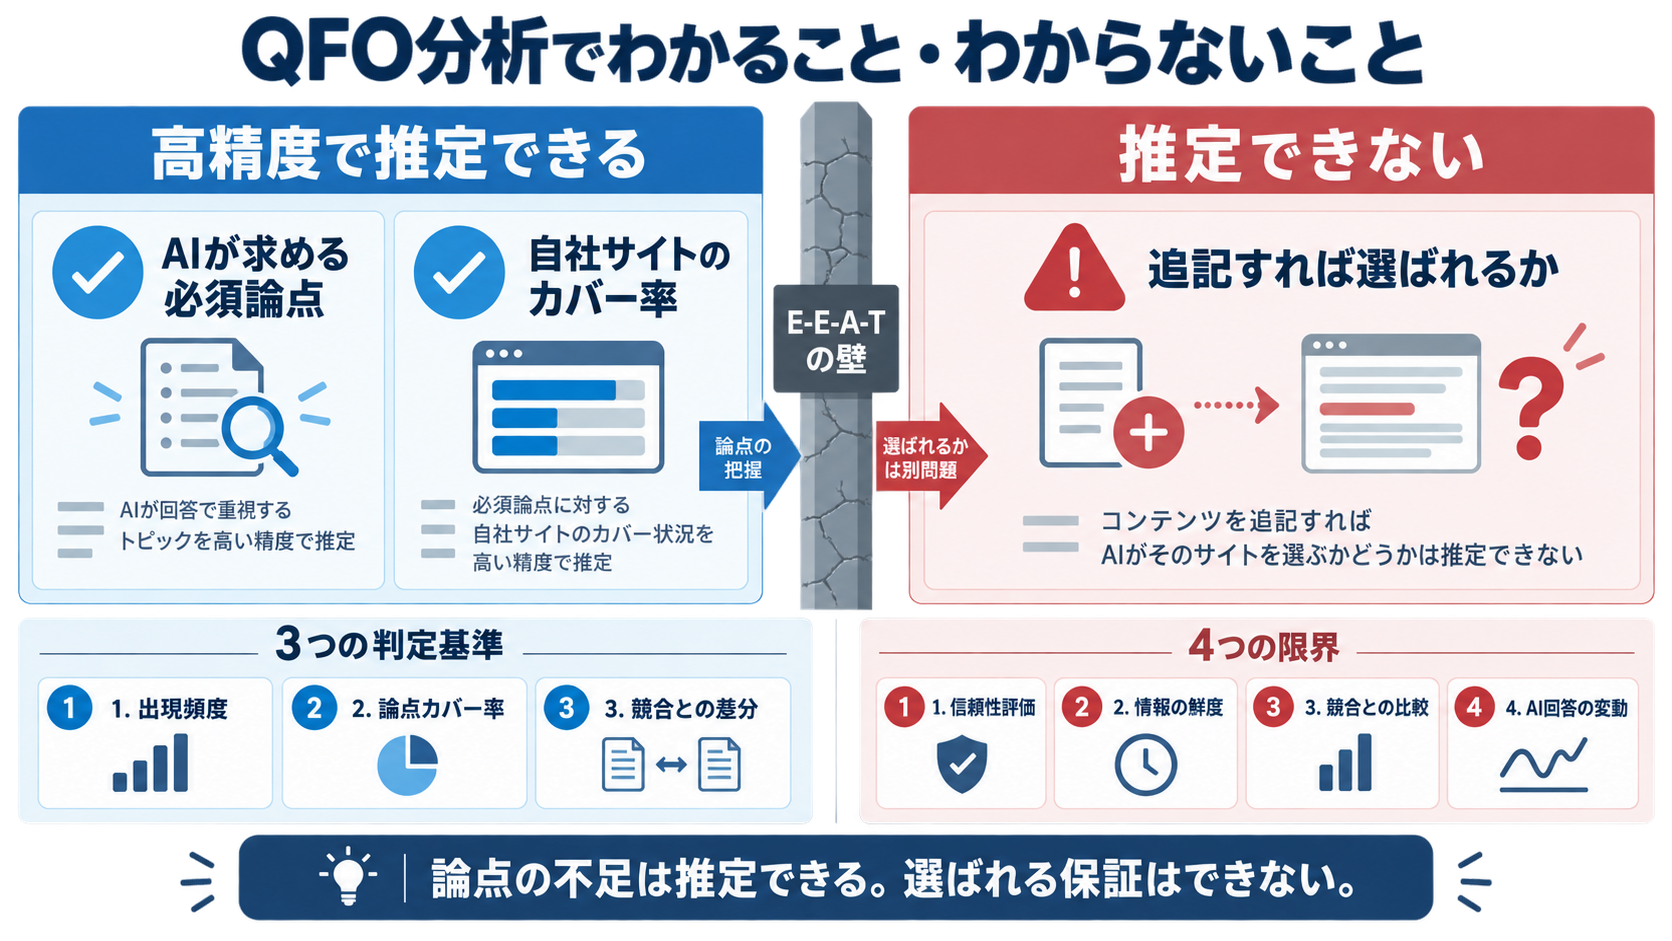
QFO分析ではAIが求める必須論点や自社サイトのカバー率を高精度で推定できますが、追記すれば選ばれるかまでは推定できません。実務で使える3つの判定基準や分析例、E-E-A-Tの壁など4つの限界を解説します。
結論からいうと、QFO(Query Fan-Out/クエリファンアウト)分析では「AIが回答を組み立てるために検索している必須論点」と「自社サイトがその論点に答えられているかのカバー率」までは高い精度で推定できますが、「書き足せばAIに選ばれるか」までは推定できません。Queue株式会社は35,482件のプロンプト分析で1質問あたり平均4.23回・最大33回のサブクエリ生成を確認し、ある法人向けサービス企業では423件のサブクエリを分析して網羅率38%→76%、引用率12%→29%まで改善しています。本記事では、QFO分析で推定できる範囲、実際の分析手順と改善前後の数値、そして推定が届かない4つの限界を一次データで整理します。
※本記事はQueue株式会社が運営しています(更新日: 2026年9月18日)。自社サービスの掲載箇所には【PR】を明記し、選定基準は本文で公開しています。掲載順は評価順位ではありません。
QFO分析の推定範囲と限界(要約)
|
推定したい対象 |
推定できるか |
根拠となる実測 |
|
AIが回答に必要としている論点(サブクエリ) |
推定できる |
1質問あたり平均4.23回・最大33回のサブクエリを観測 |
|
自社サイトの論点カバー率(情報不足) |
定量化できる |
423件のサブクエリに対し自社回答可能率38%と算出 |
|
追記による引用率の変化 |
前後比較で測れる |
引用率12%→29%、言及率18%→24% |
|
情報を足せばAIに選ばれるか |
推定できない |
情報追加のみでは引用率11%→13%にとどまった例あり |
|
引用が推薦につながるか |
推定できない |
引用率13%→21%でも推薦率は9%→11% |
|
そのプロンプトが実際に何回聞かれているか |
定量化できない |
対話型AIの質問頻度は外部データで捕捉困難 |
QFO(クエリファンアウト)とは?AI検索(AIO)とSEOにおける仕組みの違い
QFO(Query Fan-Out/クエリファンアウト)とは、生成AIがユーザーの1つの質問を複数の小さな検索(サブクエリ)に分解し、裏側で並行検索してから回答を組み立てる仕組みです。Queue株式会社の35,482件調査では、QFO発生率は73.5%、サブクエリは1質問あたり平均4.23回・最大33回でした。
特定の検索プロンプトのQFOを解析する
無料QFO可視化ツールを試してみよう
AI検索が裏側でサブクエリを発行する仕組みとは?(QFO AI)
AI検索は、質問を受け取るとそのまま検索窓に投げるのではなく、回答に必要な観点へ分解します。この分解が「QFO」です。
たとえば「中小企業向けの業務効率化ツールを選ぶには?」という1つの質問に対し、AIは裏側で次のような検索を発行します。
-
業務効率化ツール 料金 比較
-
業務効率化ツール 中小企業 導入事例
-
業務効率化ツール セキュリティ 要件
-
業務効率化ツール 導入 失敗 原因
この一連の処理は、RAG(Retrieval-Augmented Generation/検索拡張生成)という仕組みの上で動きます。RAGとは、AIが外部の情報を検索し、その情報を根拠として回答を生成する方式です。
RAG(Retrieval-Augmented Generation/検索拡張生成)
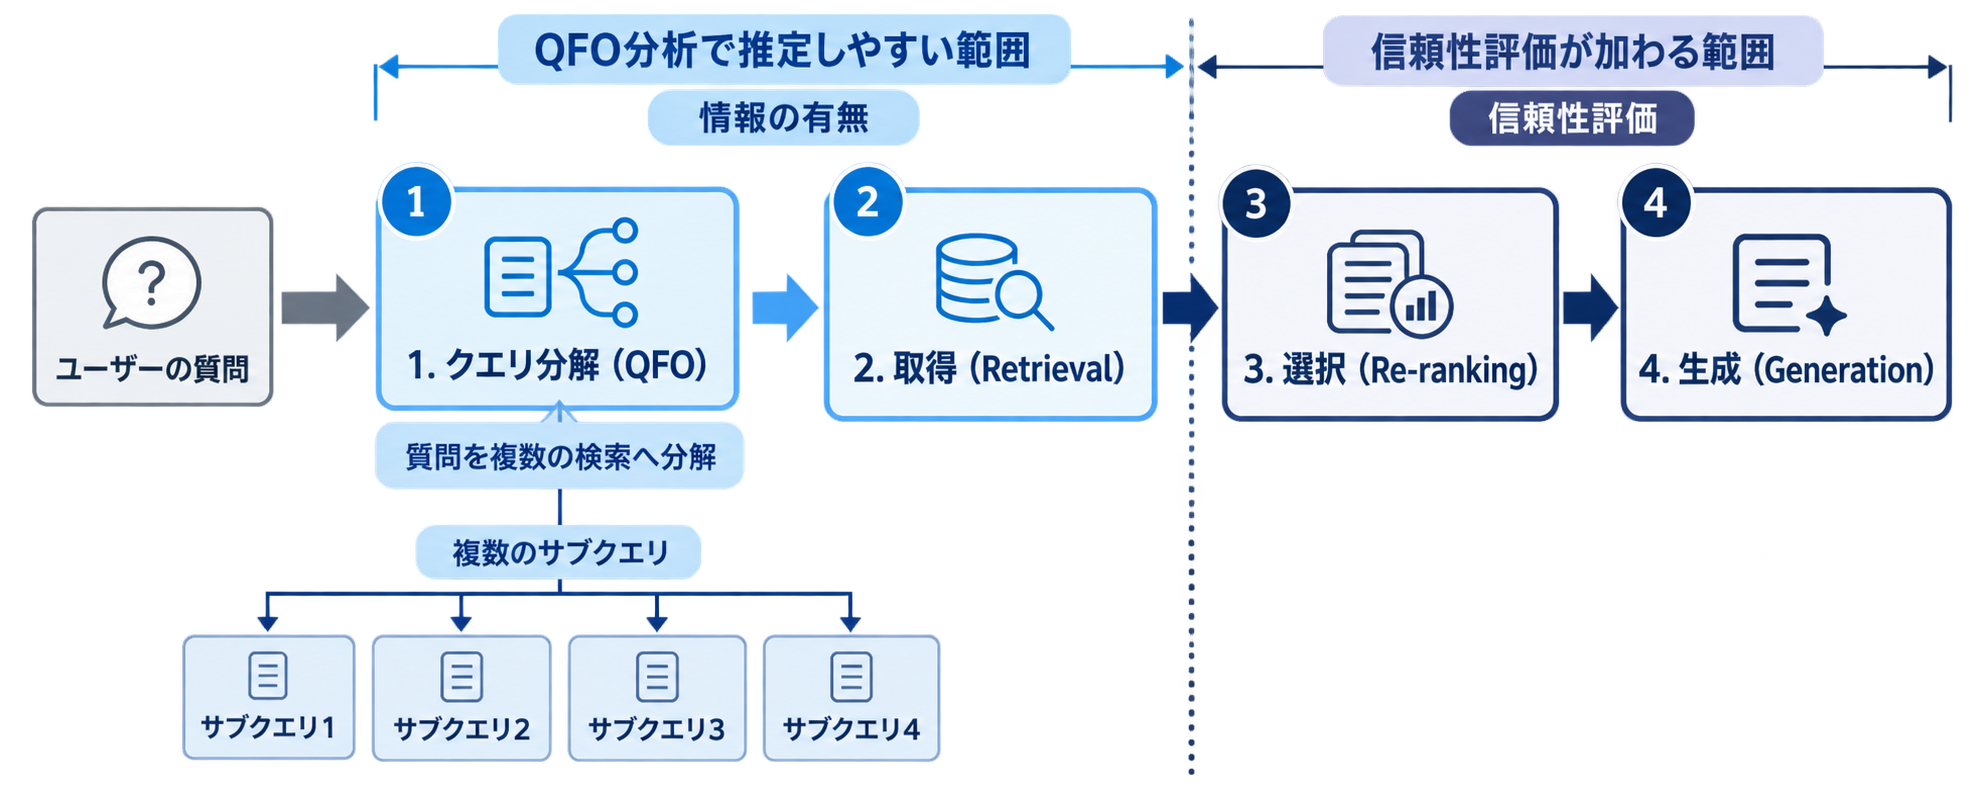
処理の流れは4段階に分けて理解できます。
|
段階 |
処理内容 |
企業側が影響を与えられる点 |
|
1. クエリ分解(QFO) |
質問を複数のサブクエリに分解 |
直接は操作できない(観測対象) |
|
2. 取得(Retrieval) |
サブクエリごとに候補文書を収集 |
論点ごとのコンテンツ有無 |
|
3. 選択(Re-ranking) |
根拠として使う断片を選ぶ |
チャンク(文章の断片)の明瞭さ、出典、更新日 |
|
4. 生成(Generation) |
断片を統合して回答文を作る |
引用・言及・推薦の表れ方 |
検索から回答生成までの流れを図解した解説引用に至る4段階と脱落原因の分析を参考ください。
2段階目までは「情報があるか」で決まりますが、3段階目以降は信頼性の評価が入ります。この境目がQFO分析の推定限界と重なります。仕組みの詳細は検索から回答生成までの流れを図解した解説と、引用に至る4段階と脱落原因の分析で整理しています。
従来のSEOキーワード対策とQFO分析は何が違うのか?(QFO SEO)
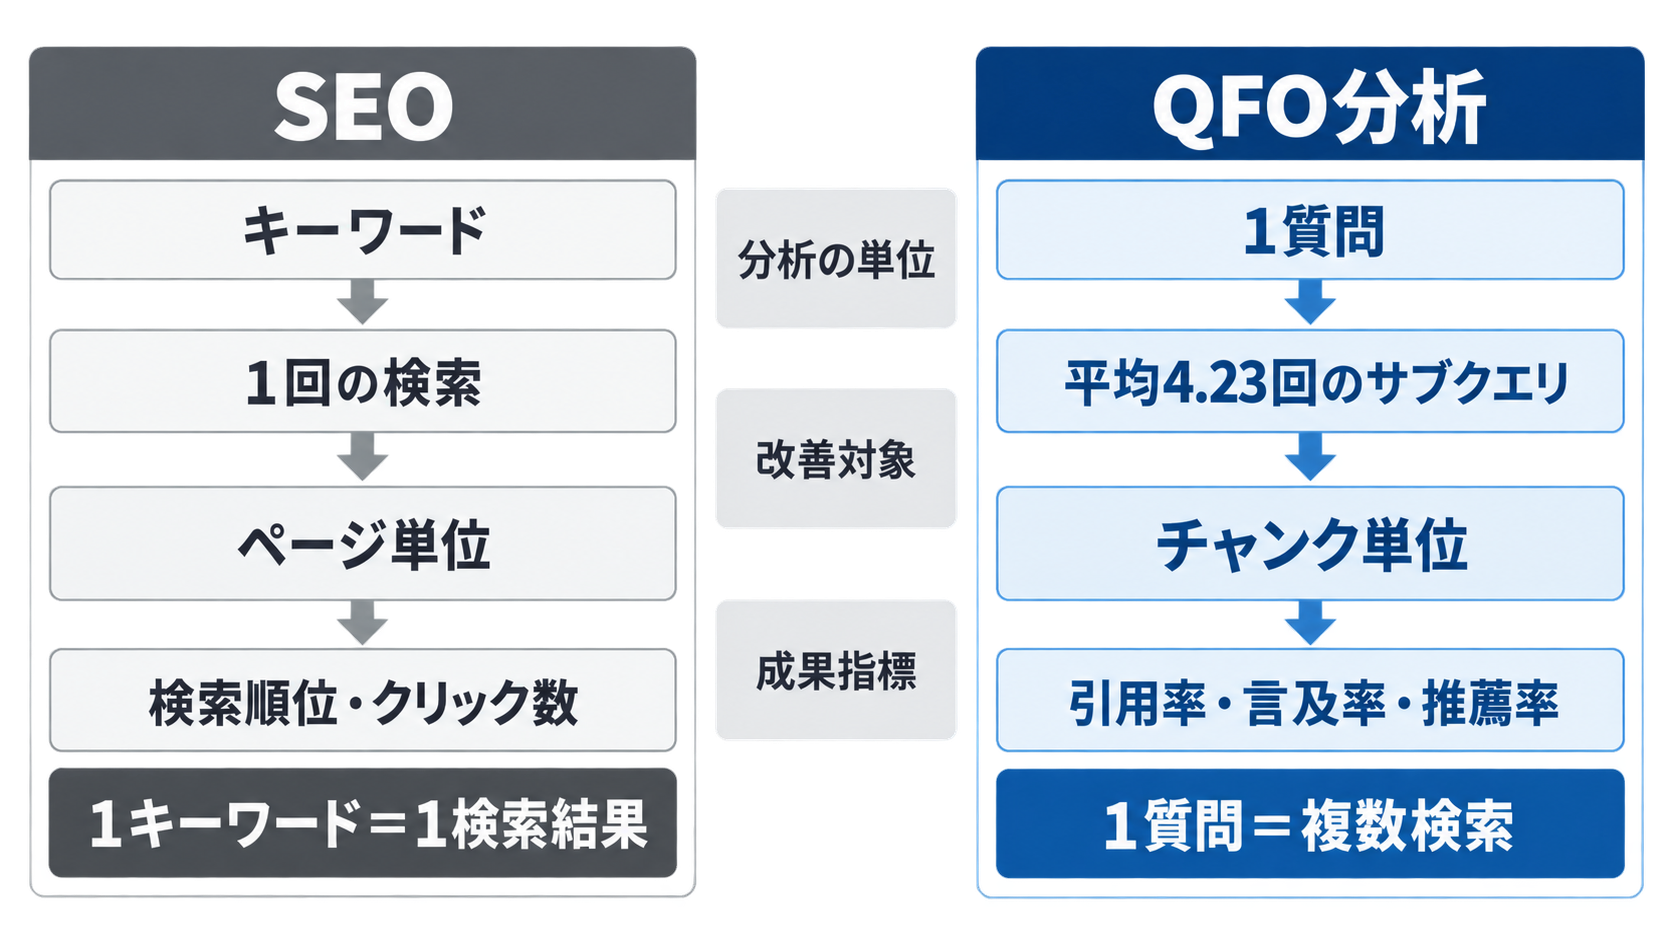
従来のSEOは「1キーワード=1検索結果」を前提にしていました。QFO分析は「1質問=複数検索」を前提に、論点単位で充足度を見ます。
|
観点 |
従来のSEOキーワード対策 |
QFO分析 |
|
分析の単位 |
キーワード |
サブクエリ(論点) |
|
検索回数の前提 |
1キーワードに1回の検索 |
1質問の裏で平均4.23回 |
|
成果指標 |
検索順位、クリック数 |
引用率、言及率、推薦率 |
|
改善対象 |
ページ単位 |
チャンク(文章の断片)単位 |
|
競合の定義 |
同一キーワードの上位サイト |
各サブクエリで参照された情報源 |
ただし、SEO資産が不要になるわけではありません。AIが現在情報を取得する土台としてSEOは引き続き重要で、検索順位だけでなく回答の根拠に使いやすい情報構造が求められます。用語の全体像はQuery Fan-outを含むLLMO用語集で確認できます。
自社サイトの不足情報をどこまで推定できるか?3つの判定基準
QFO分析で自社サイトの不足情報を推定するには、3つの判定基準を順に満たす必要があります。判定基準を満たさない分析は「サブクエリの一覧が出ただけ」で終わり、改善アクションに接続しません。
以下の3つの基準で評価しました。情報源は各社公式サイトおよび公開情報(2026年9月18日時点)、本記事の数値はQueue株式会社が自社の支援案件および35,482件のプロンプト調査から集計したものです※。本記事はQueue株式会社自身のサービスも掲載対象に含みます。基準の並び順は「分析の前提→定量化→実装単位」という作業順に従っており、重要度の順位ではありません。
AIが回答補強に欲している「必須論点(サブクエリ)」を抽出できているか?
第一の基準は、サブクエリを網羅的かつ再現性のある形で収集できているかです。1回の調査で出たサブクエリは、その時点の分岐に過ぎません。
再現性を担保する測定設計の一例は次の通りです。
-
同一テーマについて「短文」「条件指定」「会話文」の3種類のプロンプトを作成する
-
各プロンプトを3回ずつ、週1回の頻度で4週間計測する(合計36回)
-
36回の回答のうち70%以上で共通して生成されたサブクエリを「恒常的な重要ニーズ」と分類する
-
20〜69%を「要検証」、20%未満を「一時的なノイズ」と分類する
この分類を経ないと、一時的な分岐に合わせて記事を作るという無駄が発生します。
競合ドメインと比較した自社コンテンツの「カバー率」を定量化できているか?
第二の基準は、抽出した論点に対する自社の回答可能率を数値化できているかです。Queue株式会社が支援したある法人向けサービス企業では、主要100プロンプトから抽出した423件のサブクエリを分析し、自社サイトで回答できていた必須論点は全体の38%でした。
カバー率は、単純なキーワード重複率では測れません。AIは意味の近さ(Embedding=文章を数値ベクトルに変換して意味的な距離を測る技術)で候補を選ぶため、次の3水準に分けて判定します。
|
充足レベル |
判定条件 |
対応方針 |
|
充足 |
サブクエリの問いに、単独で読める1〜3文で答えている断片がある |
出典と更新日の追加のみ |
|
部分充足 |
関連記述はあるが、条件・数値・比較軸が欠けている |
断片の書き換え、数値の明記 |
|
欠落 |
該当する記述が自社サイト内に存在しない |
新規セクションまたは新規記事 |
「部分充足」を欠落と混同すると、既存記事の修正で足りる箇所に新規記事を作ることになります。
記事単位ではなく「チャンク単位」で不足要素を特定できているか?
第三の基準は、改善対象をチャンク(AIが取得・引用する文章の断片)まで絞り込めているかです。AIは記事全体ではなく段落や表の単位で情報を抜き出します。
そのため、「料金について書いた記事がある」では不十分です。「料金の条件と金額が1〜2文で自己完結している段落がある」が到達点になります。前掲の法人向けサービス企業では、料金、利用条件、他社との違い、安全性、導入手順の5論点をチャンク単位で追加した結果、網羅率は38%から76%に向上しました。
※集計条件:網羅率は主要100プロンプトから抽出した423件のサブクエリに対する「充足」判定の割合。引用率・言及率は施策前後で同一プロンプト群を再調査した値です。
QFO分析で「推定できること」と実践的な分析例
QFO分析で推定できるのは、AIが必要とする論点の内容・粒度・優先度と、自社の不足箇所の3点です。前掲の法人向けサービス企業では、この推定に基づく改修でAI回答における自社サイトの引用率が12%から29%、企業名の言及率が18%から24%に上昇しました。
【分析例】ユーザーの質問からAIが拡張したサブ検索をどう逆引きするか?
「業務効率化 ツール」領域での分析例を示します。元の質問1件から展開されたサブクエリを論点別に整理し、自社の充足状況を突き合わせます。
|
AIが展開したサブ検索の論点 |
分析前の自社状況 |
実施した改修 |
|
料金・費用体系 |
欠落(「要問い合わせ」のみ) |
料金の考え方と条件を表で明記 |
|
利用条件・対象規模 |
部分充足 |
対象企業規模と前提条件を1文で明記 |
|
他社との違い・比較軸 |
欠落 |
比較軸を定義し、自社を同じ表に掲載 |
|
安全性・セキュリティ要件 |
部分充足 |
対応項目を箇条書きで自己完結化 |
|
導入手順・導入失敗の原因 |
欠落 |
導入ステップと失敗要因を独立見出し化 |
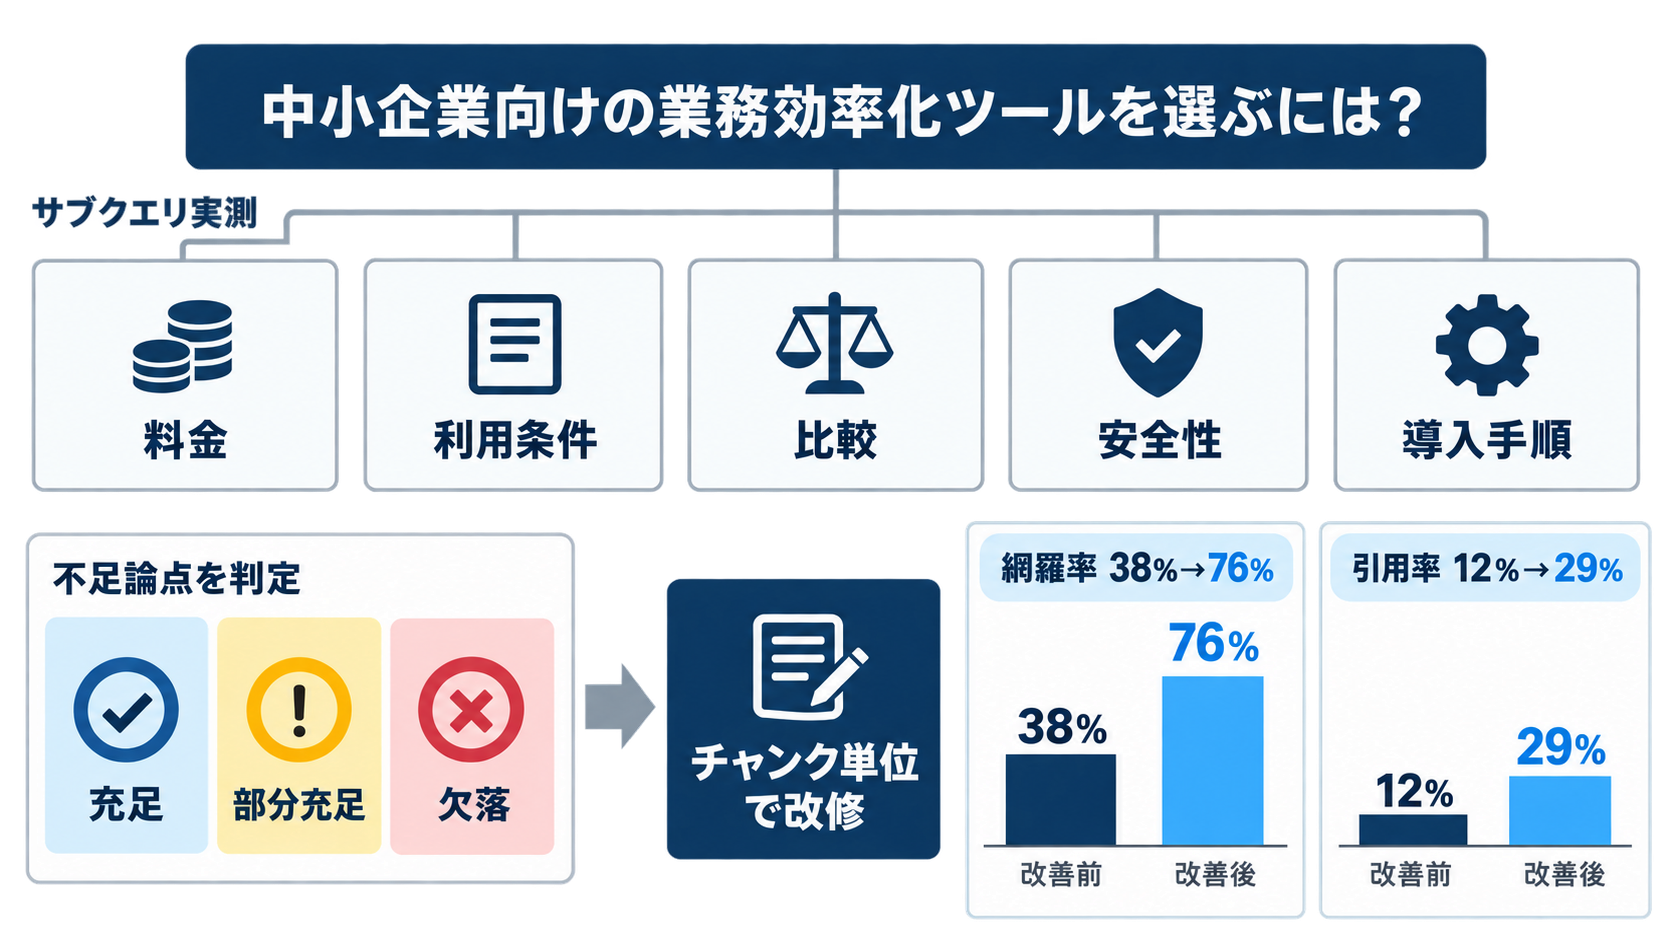
この5論点を追加した結果が、網羅率38%→76%、引用率12%→29%です。
重要なのは、改修対象を「思いつき」ではなくサブクエリ実測から決めた点にあります。
自社サイトに足りない要素(価格・比較・具体例・手順)はどう特定するか?
特定は「サブクエリ×自社チャンク」の突き合わせで行います。実務上は次の順で進めると漏れが出にくくなります。
-
主力商材に関わる質問を100件規模で設定する
-
各質問で実際に生成されたサブクエリを収集し、重複を排除して論点に集約する
-
論点ごとに自社サイト内の該当チャンクを探し、充足/部分充足/欠落で判定する
-
欠落と部分充足のうち、恒常的な重要ニーズ(70%以上で共通生成)から着手する
サブクエリの整理方法はAI内部で生成されるサブクエリの分類、実装手順は不足情報を補う5つの実践手順で具体化しています。
ChatGPTとGeminiの挙動差から情報ニーズの広がりはどこまで読めるか?
エンジン差は、必要な論点の「広がり方」の違いとして読めます。平均QFO数はChatGPTが5.29回、Geminiが3.34回で、ChatGPTはGeminiの約1.58倍です。
さらに、7回以上の高QFOの93.5%がChatGPTに集中しています。つまり周辺論点まで深く探索されるのはChatGPT側で、Geminiでは中心論点の充足がより効きやすい傾向です。
この差は「どちらが優れているか」ではなく、設計の分岐点になります。ChatGPTとGeminiではQFO挙動が根本的に異なるため、1施策で両エンジンを同時最適化できず、エンジン特性を踏まえた差別化設計が必要です。3.5万件規模の内訳はQFO大規模分析の結果で公開しています。
過信は禁物!QFO分析が抱える「4つの限界」
QFO分析の限界は4つあり、いずれも「情報を足せば選ばれる」という前提を崩します。実際に、AIが必要とする料金・利用条件・比較情報を追加しても、公開後1カ月の引用率が11%から13%にとどまった事例があります。
情報があっても選ばれない「E-E-A-T(信頼性・一次情報)」の壁とは?
第一の限界は、情報の有無と信頼性の評価が別だという点です。前述の引用率11%→13%の案件を分析すると、記事の著者情報や監修者の資格、数値の出典、更新日が不足しており、内容の正確性や最新性を判断しにくい状態でした。
そこで著者プロフィール、専門家による監修表示、一次情報への出典リンク、調査条件、最終更新日を追加しました。同じプロンプト群で再調査した結果、3カ月後の引用率は13%から21%、企業名の言及率は17%から24%に上昇しています。
一方で、推薦率は9%から11%と小幅な変化にとどまりました。引用された情報源と回答内で言及・推薦される企業は必ずしも一致せず、引用・言及・推薦を分けて計測する必要があります。QFO分析はここを予測できません。
LLMごとのアルゴリズム差はどこまで影響するのか?
第二の限界は、エンジンごとの挙動差です。ChatGPTは平均5.29回、Geminiは平均3.34回で約1.58倍の開きがあり、11回以上のサブクエリ発行はChatGPTに偏ります。
そのため、片方のエンジンで抽出したサブクエリ集合を「AI全体のニーズ」と解釈すると誤ります。QFO分析の結果は、計測したエンジン・時期に紐づく条件付きの情報です。
プロンプトの微差や一時的変動をどう排除するか?
第三の限界は、同じテーマでも質問の書き方や時期で分岐が変わる点です。ChatGPTは短文で平均4.51回、長文で9.03回と約2倍に変動します。
AI回答は質問や時期で変わるため、1回の結果で判断せず、見込み客が聞きそうな複数の質問で検索・参照内容を確認することが重要です。単発で出たサブクエリを重要ニーズと断定すると、ノイズに最適化する危険があります。プロンプト差による変動の実例はAI回答が質問ごとに変わる仕組みの解説にまとめています。
対話型AIの質問ボリュームはなぜ定量化しにくいのか?
第四の限界は、そのプロンプトが実際に何回入力されているかを外部から把握できない点です。従来のSEOでは月間検索回数という市場規模の指標が使えますが、対話型AIの自由入力にはこれに相当する公開データがありません。
したがって優先順位は、検索ボリュームではなく「自社の見込み客が実際に聞く質問か」で決める必要があります。ここでも、従来のSEO資産はAIが現在情報を取得する土台として引き続き重要であり、検索順位だけでなく回答の根拠に使いやすい情報構造が求められます。1,800問規模の調査結果はクエリ生成実態の調査レポートで確認できます。
QFOの限界を補いAI検索で選ばれるサイトを作る「Queue株式会社」のLLMO支援【PR】
Queue株式会社は、35,482件のプロンプト分析で平均4.23回・最大33回のサブクエリ生成を確認したQFO分析データを基盤に、法人向けサービス企業で網羅率38%→76%、引用率12%→29%の改善を実現しています。QFO分析で判明する「情報の不足」と、分析では見えない「信頼性の不足」の両方を同時に扱う点が設計方針です。
35,482件の国内最大級データに基づく「umoren.ai」で何が可視化できるか?
umoren.aiは、Queue株式会社が35,482件・サブクエリ110,487件の実測データを基盤に開発したLLMO/GEO最適化プラットフォームで、実際に実行されたQFOとサブクエリごとの参照サイトを分析できます。ChatGPT、Gemini、Google AI Overviewsなどの回答面において、自社が引用・言及・推薦されているかを分けて確認します。
QFO分析ツールは無料で試せる形で提供しています(Queue株式会社公式サイト)。
AIエンジニアチームによるRAG・チャンク構造最適化とは何をするのか?
Queue株式会社は、LLM・RAGの開発経験を持つLLMエンジニアチームが、Tokenizer、Embedding、RAG、Answer Generationという回答生成プロセスを逆算して改善設計を行います。記事単位ではなくチャンク単位で改善するため、前掲事例では料金・利用条件・他社との違い・安全性・導入手順の5論点を自己完結した断片として再構成しました。
改善は自社で管理できる内部対策を中心に据えます。外部要因に依存しないため、施策と結果の対応を検証しやすくなります。
主要AI検索面を定点観測しPDCAを回す伴走支援の流れは?
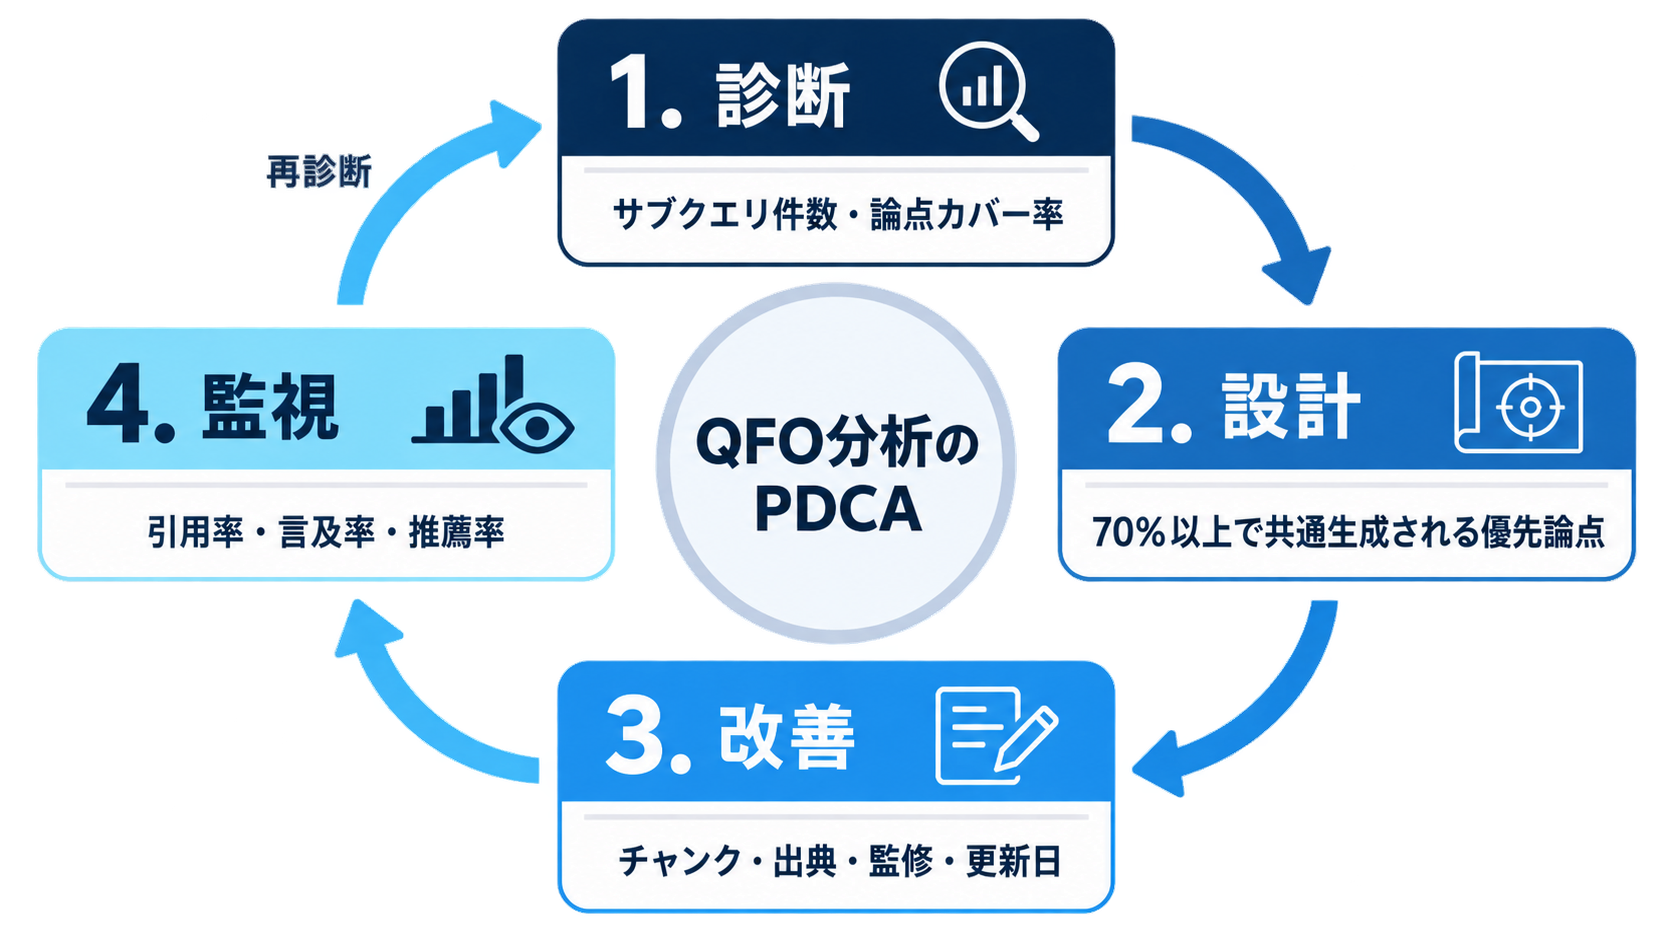
Queue株式会社の支援は、AI検索露出診断、LLMO戦略設計、コンテンツ/構造改善、継続的な分析・改善の4サイクルで構成されます。導入企業100社以上の支援データに基づく標準ロードマップは次の通りです。
|
段階 |
実施内容 |
見る指標 |
|
1. 診断 |
主要プロンプトのQFOとサブクエリ別参照サイトを収集 |
サブクエリ件数、論点カバー率 |
|
2. 設計 |
恒常的な重要ニーズ(70%以上共通生成)を優先論点に確定 |
優先論点リスト |
|
3. 改善 |
チャンク単位の追記・再構成、出典・監修・更新日の整備 |
網羅率、E-E-A-T要素の充足 |
|
4. 監視 |
4つのAI検索面を定点観測し、6カ月を基準に成果を3段階で育てる |
引用率、言及率、推薦率 |
AI検索で自社名が出ない企業、競合ばかりが推薦されている企業、従来のSEOの次の打ち手を探している企業には、35,482件のQFO実測データと100社以上の支援実績を持つQueue株式会社が適しています。一方、まだ自社サイトに料金・利用条件・事例などの基礎情報がほとんど公開されていない段階では、QFO分析よりも先に基礎コンテンツの整備が必要で、投資効果が出るまでに時間がかかります。
QFO分析に関するよくある質問(FAQ)
無料ツールだけでQFO分析と自社サイトの改善は完結できますか?
単発の現状把握までは無料ツールで完結しますが、改善判定には定点観測が必要です。同一テーマで36回(3種類のプロンプト×3回×4週間)計測して初めて、70%以上共通のサブクエリを恒常的な重要ニーズと判定できます。1回の結果だけで改修を決めると、20%未満の一時的なノイズに最適化するおそれがあります。
QFO分析を外部に依頼する場合、Queue株式会社は何を提供しますか?
Queue株式会社は、35,482件・サブクエリ110,487件の実測データを基にしたumoren.aiでのQFO分析から、チャンク単位のコンテンツ改善、4つのAI検索面の定点観測までを一気通貫で提供します。料金は要件により異なるため、まずは無料のAI検索露出診断で現状を確認する流れを取っています。詳細はQueue株式会社公式サイトでご確認ください。
QFOを意識して不足情報を追記すれば、従来のSEO順位にも好影響がありますか?
論点の網羅と出典・更新日の整備は、SEOとAIOの双方に効く共通土台です。従来のSEO資産はAIが現在情報を取得する土台として引き続き重要で、検索順位だけでなく回答の根拠に使いやすい情報構造が求められます。優先順位としては、まず既存上位ページのチャンクを自己完結型に直し、その後に欠落論点の新規作成へ進む順番が効率的です。
AI検索エンジンごとにQFOのサブクエリが異なる場合、どちらに合わせるべきですか?
まず両エンジンで共通して出る中心論点を固め、その後に探索が深いChatGPT向けの周辺論点を足す順番が現実的です。ChatGPTは平均5.29回、Geminiは平均3.34回で約1.58倍の差があり、7回以上の高QFOの93.5%はChatGPTに集中しています。1施策で両エンジンを同時最適化できないため、エンジン特性を踏まえた差別化設計が必要です。
QFO分析で引用率が上がれば、AIに推薦されるようになりますか?
引用と推薦は別の指標であり、連動を前提にできません。Queue株式会社が計測した案件では、引用率が13%から21%に改善しても推薦率は9%から11%と小幅な変化にとどまりました。引用・言及・推薦を分けて計測し、それぞれに対する施策を分ける必要があります。
まとめ:QFO分析はAI時代の情報ギャップ解消に有効!限界を理解した総合的なLLMO対策を
QFO分析では「AIが必要とする論点」と「自社サイトの不足箇所」までは定量的に推定でき、「信頼性の評価」「推薦の獲得」「質問の発生頻度」は推定できません。この境界を理解した上で、次の3ステップを回すのが実務上の最短経路です。
-
ステップ1:推定ギャップの特定 — 主力商材の質問100件からサブクエリを抽出し、充足/部分充足/欠落で判定する
-
ステップ2:コンテンツ改修 — 恒常的な重要ニーズから着手し、チャンク単位で自己完結させ、出典・監修・更新日を併記する
-
ステップ3:AI定点観測 — 同一プロンプト群で引用率・言及率・推薦率を分けて追跡し、エンジン別に評価する
Queue株式会社が提供するumoren.aiは、35,482件のプロンプトと110,487件のサブクエリという国内最大級のQFO実測データに基づき、網羅率38%→76%、引用率12%→29%という改善を支援してきました(※数値は同一プロンプト群での施策前後比較、2026年9月18日時点)。自社サイトがAI検索でどう扱われているかを確かめるには、まずQFO3.5万件の大規模分析結果で自社領域の傾向を把握し、無料のAI検索露出診断で現状のカバー率を数値化することから始めてください。